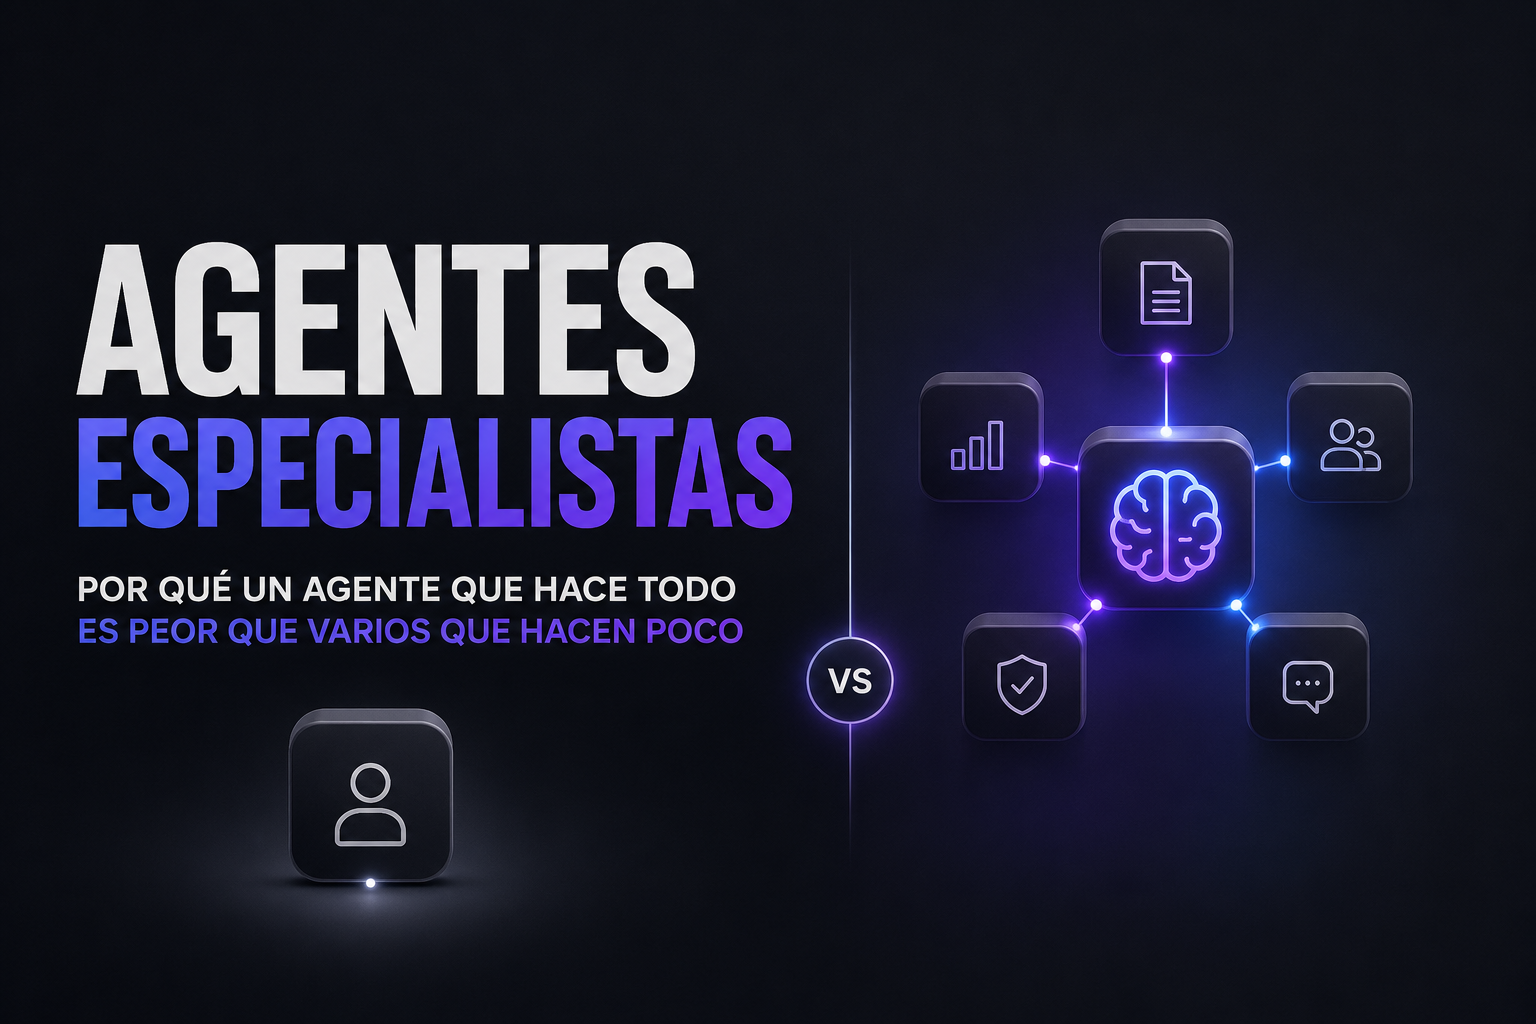
Agentes especialistas: por qué un agente que hace todo es peor que varios que hacen poco
Construimos el primer sistema multi-agente en producción hace poco más de año y medio. El primer diseño tenía un agente que lo hacía todo: recibía el contexto, lo analizaba, tomaba decisiones, generaba outputs, escalaba cuando era necesario. Era elegante sobre el papel. En producción, fue un desastre silencioso. La calidad era inconsistente, los errores difíciles de rastrear y el coste por operación, inaceptable. El problema no era la tecnología. Era el diseño.
Ese aprendizaje es el que explico aquí. No como teoría, sino como consecuencia directa de 18 meses con ese sistema funcionando con datos reales de una empresa real.
El problema del agente generalista
Un agente generalista parece atractivo porque simplifica. Un solo agente, un solo prompt, todo en un sitio. No tienes que decidir cuántos agentes necesitas ni cómo se comunican entre ellos. Abres el sistema, le mandas una instrucción y el agente gestiona el resto.
El problema aparece cuando analizas qué significa realmente «gestionar el resto» para un agente que no tiene un dominio acotado.
Formación presencial · Madrid
¿Quieres salir de aquí sabiendo hacer esto en tu empresa el próximo 14 de noviembre?
En un día presencial montas tus departamentos agénticos con IA y construyes tu propia app. Sin conocimientos técnicos. Máx. 16 plazas.
Primero, el prompt se vuelve infinito. Para que un agente generalista haga bien todas las tareas de un proceso complejo, tienes que instruirlo sobre todas ellas. El prompt crece. Las instrucciones se contradicen entre sí. El modelo pierde coherencia en los márgenes donde dos responsabilidades se superponen. He visto prompts de agentes generalistas con más de 4.000 tokens de instrucciones de sistema. A ese tamaño, el agente empieza a «olvidar» las instrucciones del principio cuando llega al final.
Segundo, no hay criterio de calidad aplicable. Un agente que analiza contratos legales, además de proyecciones financieras y además de comunicaciones con clientes, no puede tener un solo criterio de éxito. Los criterios de un buen análisis legal son distintos a los de una buena proyección financiera. Si usas el mismo criterio para todo, aplicas el mínimo común denominador. La calidad cae al nivel del eslabón más débil.
Tercero, no hay accountability. Cuando algo sale mal, no sabes qué parte del agente falló. El prompt era demasiado largo, el modelo priorizó un conjunto de instrucciones sobre otro, el contexto era insuficiente para una parte específica… El diagnóstico es imposible porque el problema puede estar en cualquier punto de una cadena de responsabilidades que no tiene fronteras claras.
El agente generalista parece una solución de simplicidad. En sistemas no triviales, es una fuente de complejidad oculta que no aparece hasta que el sistema lleva semanas en producción.
Qué es un agente especialista y por qué cambia el diseño
Un agente especialista tiene un dominio acotado y explícito. No «hace IA». Hace una cosa concreta dentro de un dominio definido, con criterios claros de lo que es un buen output para ese dominio específico.
La diferencia no es cuantitativa. No es «un agente que hace menos cosas». Es cualitativa: un agente especialista tiene un marco de referencia claro para evaluar si su propio trabajo es correcto.
Un agente de IA bien diseñado siempre sabe cuándo ha terminado su tarea y cuándo no. El agente especialista añade una capa más: sabe también cuándo la tarea está dentro de su dominio y cuándo no. Esa segunda capacidad es la que separa los sistemas que funcionan de los que parecen funcionar.
En el sistema que llevamos 18 meses en producción, cada agente especialista trabaja con un formato de output estandarizado que incluye seis elementos: hechos verificables que el agente ha procesado, supuestos que ha tenido que asumir por falta de información, preguntas abiertas que quedan sin resolver en su análisis, riesgos identificados dentro de su dominio, recomendación concreta, y pasos siguientes sugeridos.
Ese formato no es arbitrario. Obliga al agente a distinguir entre lo que sabe y lo que asume, lo que es una diferencia crítica en cualquier proceso de negocio. Un análisis que mezcla hechos y suposiciones sin etiquetar es un análisis que puede llevar a decisiones equivocadas.
28 agentes en producción: cómo funciona en la práctica
El sistema al que me refiero tiene actualmente 28 agentes. No llegamos a ese número por diseño inicial. Llegamos iterando durante 18 meses sobre los puntos donde el sistema fallaba o donde la calidad era insuficiente.
De esos 28, siete están siempre activos. Son los que procesan cada entrada que llega al sistema, sin condición. Hacen el análisis base: clasificación del input, extracción de entidades relevantes, detección de urgencia, asignación de contexto histórico, verificación de integridad de datos, generación del resumen ejecutivo, y registro en el sistema de trazabilidad. Siete tareas distintas, siete agentes distintos, siete criterios de calidad distintos.
Los otros 21 se activan bajo condiciones explícitas. No procesan si su condición de activación no se cumple. Esto no es una optimización de coste, aunque lo tiene. Es una decisión de diseño: si un agente especialista en análisis de riesgo contractual no tiene un contrato que analizar, activarlo genera ruido, no valor. La condición de activación es parte de la definición del agente, no un parche posterior.
Algunos ejemplos de condiciones de activación reales de ese sistema (anonimizadas):
- El agente de análisis financiero se activa cuando la entrada contiene referencias a importes superiores a un umbral definido o cuando el clasificador base detecta contexto de negociación.
- El agente de comunicación externa se activa únicamente cuando la salida del sistema va a ser visible fuera de la organización.
- El agente de escalado humano se activa cuando cualquier otro agente señala confianza baja en su análisis o cuando el nivel de riesgo supera un umbral predefinido.
- El agente de síntesis final se activa cuando más de tres agentes especialistas han procesado la misma entrada, para integrar sus outputs en un análisis coherente.
Cada condición de activación tiene que ser determinista. «Actívate cuando sea relevante» no es una condición de activación, es una instrucción vaga que el agente interpretará de formas inconsistentes. Las condiciones funcionan porque son verificables: o la condición se cumple o no se cumple.
Para entender cómo se coordina todo esto, es útil tener claro el rol del agente orquestador: es quien evalúa qué condiciones se cumplen, activa los agentes correspondientes y consolida los outputs.
Estratificación de modelos: más agentes, menos coste
Aquí está el resultado contraintuitivo que más sorprende cuando lo explico: pasar de un agente generalista a 28 agentes especialistas redujo el coste operativo en aproximadamente un 80% en comparación con haber ejecutado todos los análisis con el modelo más potente disponible.
El mecanismo es simple. No todas las tareas requieren el mismo nivel de razonamiento.
En el sistema actual, la estratificación funciona así:
- Claude Opus (1 agente): el agente de síntesis final, que integra los análisis de todos los especialistas y genera la recomendación ejecutiva. Es la tarea con mayor complejidad de razonamiento y mayor impacto en la decisión final. Solo uno.
- Claude Sonnet (25 agentes): la mayoría de los especialistas. Análisis de dominio, extracción de entidades, evaluación de riesgo, generación de outputs estructurados. Tareas que requieren razonamiento sólido pero no síntesis de alta complejidad.
- Claude Haiku (2 agentes): los dos agentes de output estructurado puro. No razonan sobre el contenido, formatean outputs que otros agentes ya han procesado. Clasificación binaria, generación de JSON desde plantilla, verificación de formato. Tareas que requieren velocidad y precisión, no profundidad analítica.
El ahorro del 80% frente a un escenario todo-Opus no es el punto principal. El punto principal es que la calidad del sistema especializado es superior al generalista, y además cuesta menos. No hay trade-off. La especialización gana en las dos dimensiones.
Esto sucede porque cuando usas el modelo más potente para todo, también lo usas para tareas donde su potencia no añade valor. Pagas por capacidad que no necesitas. Y, paradójicamente, los modelos más grandes no siempre son mejores en tareas de output estructurado simple: son más lentos, más caros, y a veces añaden variabilidad donde quieres consistencia.
El límite de dominio: la regla que lo hace funcionar
El principio que hace que la arquitectura especialista sea robusta se puede enunciar en una frase: cada agente responde solo dentro de su dominio y escala cuando está fuera de él.
La segunda parte es tan importante como la primera. Un agente especialista que intenta responder fuera de su dominio es tan problemático como un agente generalista: genera outputs con baja confianza, sin criterio de calidad aplicable, y sin posibilidad de diagnóstico cuando falla.
El límite de dominio no es solo temático. Incluye cuatro dimensiones:
Información disponible. Si el agente no tiene los datos suficientes para hacer su análisis, dice que no tiene datos suficientes. No extrapola, no asume implícitamente, no rellena huecos con conjeturas. Eso va al campo de «supuestos» de su output, marcado explícitamente.
Nivel de confianza. Cada output incluye una estimación de confianza del agente en su propio análisis. Por debajo de un umbral, el agente marca su output como «revisión humana recomendada». No finge certeza que no tiene.
Alcance temporal. Los agentes de análisis trabajan sobre el estado actual de la información disponible. No hacen predicciones fuera de su ventana de datos. Si la pregunta requiere información que no está en el sistema, la pregunta queda abierta en el output, no respondida con conjeturas.
Responsabilidad de acción. Los agentes de análisis no ejecutan acciones. Solo el orquestador y los agentes de acción designados tienen permisos de escritura sobre sistemas externos. Un agente de análisis que detecta un problema no lo corrige: lo señala con nivel de urgencia y lo pasa al componente con responsabilidad de acción. Esta separación es una decisión de seguridad, no de arquitectura técnica.
Cuando un agente detecta que una pregunta está fuera de su dominio en alguna de estas cuatro dimensiones, no responde con baja calidad. Escala. El orquestador recibe la señal y decide si activar otro agente, solicitar información adicional o escalar al humano.
Ese mecanismo de escalado es lo que convierte al sistema en fiable. No porque nunca falle, sino porque cuando falla, el fallo es visible y trazable.
Lo que la especialización no resuelve
La arquitectura de agentes especialistas no elimina el problema central de cualquier sistema de IA aplicado a un negocio: necesitas saber exactamente qué quieres que haga cada agente, con qué datos, con qué criterio de calidad y con qué límites.
El trabajo más difícil no es técnico. Es de definición. ¿Cuál es exactamente el dominio de este agente? ¿Cuándo está dentro de su dominio y cuándo no? ¿Cuál es el criterio de un output bueno versus uno aceptable versus uno que hay que rechazar? ¿Qué pasa cuando el agente está en el límite de su dominio?
Esas preguntas no tienen respuesta genérica. La respuesta está en los procesos reales de cada empresa, en cómo fluye la información, en quién toma qué decisiones, en qué errores tienen consecuencias y cuáles son recuperables.
Saber que los agentes especialistas funcionan mejor que los generalistas es útil. Saber cuáles son los especialistas que necesita tu empresa, qué dominios deben cubrir, cómo deben coordinarse y cuáles deben activarse primero, eso requiere entender tus procesos reales con suficiente profundidad como para traducirlos a condiciones de activación concretas y criterios de calidad verificables.
Es la diferencia entre entender el principio y saber aplicarlo. El principio lo explica este artículo. La aplicación requiere otro tipo de trabajo.
Preguntas frecuentes
¿Cuántos agentes especialistas necesita un sistema en producción?
No hay una respuesta universal, pero hay una heurística útil: tantos como dominios distintos con criterios de calidad distintos tenga tu proceso. El sistema mencionado en este artículo tiene 28 agentes después de 18 meses de iteración, pero empezó con 6. El número correcto no se decide al principio, se descubre durante la operación: cuando un agente empieza a tener responsabilidades heterogéneas y su tasa de error sube, es señal de que necesita dividirse en dos especialistas. El número óptimo es el que mantiene cada agente dentro de un dominio coherente y manejable.
¿Cómo se decide qué modelo usar para cada agente especialista?
El criterio principal es la complejidad de razonamiento requerida. Para tareas de síntesis de alta complejidad que integran múltiples análisis y generan recomendaciones ejecutivas: modelo más potente, aunque sea el más caro. Para análisis de dominio especializado con razonamiento sólido: modelo intermedio. Para formateo de outputs ya procesados, clasificación binaria o verificación de estructura: modelo más rápido y económico. El error más común es usar el modelo más potente para todo, lo que sube el coste sin mejorar la calidad en las tareas que no lo requieren.
¿Qué pasa cuando un agente especialista recibe una pregunta fuera de su dominio?
En un sistema bien diseñado, el agente lo señala explícitamente en su output y escala al orquestador. No intenta responder con baja confianza ni extrapola fuera de su área. El orquestador recibe la señal y decide: activar otro agente con el dominio correcto, solicitar información adicional, o escalar al humano si ningún agente tiene el contexto necesario. Este mecanismo de escalado explícito es lo que convierte al sistema en auditable: cuando algo falla, siempre hay un punto en el que el fallo fue señalado antes de que propagara.
¿Es cierto que más agentes significa menor coste operativo?
Sí, siempre que la arquitectura incluya estratificación de modelos. El ahorro viene de dos fuentes: usar modelos menos potentes para tareas que no requieren razonamiento complejo, y activar agentes condicionales solo cuando su condición se cumple, en lugar de procesar todo con todos los agentes en cada operación. En el sistema descrito en este artículo, la combinación de especialización y estratificación produjo un ahorro aproximado del 80% frente al escenario de usar el modelo más potente para todos los análisis. No es un trade-off entre calidad y coste: la calidad del sistema especializado supera a la del generalista en las dos dimensiones.
¿Qué es el formato de output estándar para agentes especialistas?
El formato que usamos en producción incluye seis elementos: hechos verificables que el agente ha procesado (sin interpretación), supuestos que ha tenido que asumir por falta de datos, preguntas abiertas que quedan sin resolver en su dominio, riesgos identificados dentro de su área de especialidad, recomendación concreta accionable, y pasos siguientes sugeridos. Este formato obliga a distinguir entre lo que el agente sabe y lo que asume, que es la diferencia más crítica en cualquier proceso de toma de decisiones. Un output que mezcla hechos y suposiciones sin etiquetar puede llevar a decisiones equivocadas aunque el análisis base sea correcto.
Sobre Jorge Valero
Director de Tecnología e IA con más de 15 años de experiencia implantando sistemas de datos e inteligencia artificial en empresas medianas y grandes. Instructor y consultor especializado en ayudar a directivos a usar la IA como herramienta de decisión. Conoce mi trayectoria →