Cómo un sistema de IA aprende de sus errores y mejora solo (self-improvement loop)
La mayoría de los sistemas de IA no aprenden de sus errores. Los repiten. No porque la tecnología no lo permita, sino porque nadie diseñó el proceso para que ocurriera. El self-improvement loop —o bucle de mejora continua— es exactamente eso: un proceso estructurado que convierte cada caso cerrado en una lección, y cada lección en una regla mejor. No es magia. Es ingeniería.
En este artículo explico cómo funciona ese proceso, qué hace que una lección valga la pena guardar y por qué el filtro humano es la pieza que lo hace sostenible.

El problema real: los sistemas de IA no mejoran solos
Cuando una empresa instala un agente de IA —para gestión de contratos, soporte interno, análisis financiero, lo que sea— lo más habitual es que ese agente sea igual de bueno o malo en el caso 200 que en el caso 1. El sistema no acumula experiencia. No conecta lo que salió mal en marzo con lo que está pasando en octubre.
Esto no es un defecto del modelo subyacente. Es un defecto de diseño. Los modelos de lenguaje, por sí solos, no tienen memoria persistente entre sesiones. Cada conversación empieza desde cero. Pero eso no significa que el sistema tenga que empezar desde cero. La diferencia está en qué construyes alrededor del modelo.
Formación presencial · Madrid
¿Quieres salir de aquí sabiendo hacer esto en tu empresa el próximo 14 de noviembre?
En un día presencial montas tus departamentos agénticos con IA y construyes tu propia app. Sin conocimientos técnicos. Máx. 16 plazas.
Un sistema de IA con mejora continua separa dos cosas que normalmente se confunden: el modelo (que no cambia) y las instrucciones que guían al modelo (que sí pueden mejorar). El self-improvement loop actúa sobre las instrucciones, no sobre los pesos del modelo.
Cómo funciona el bucle: de caso cerrado a regla mejorada
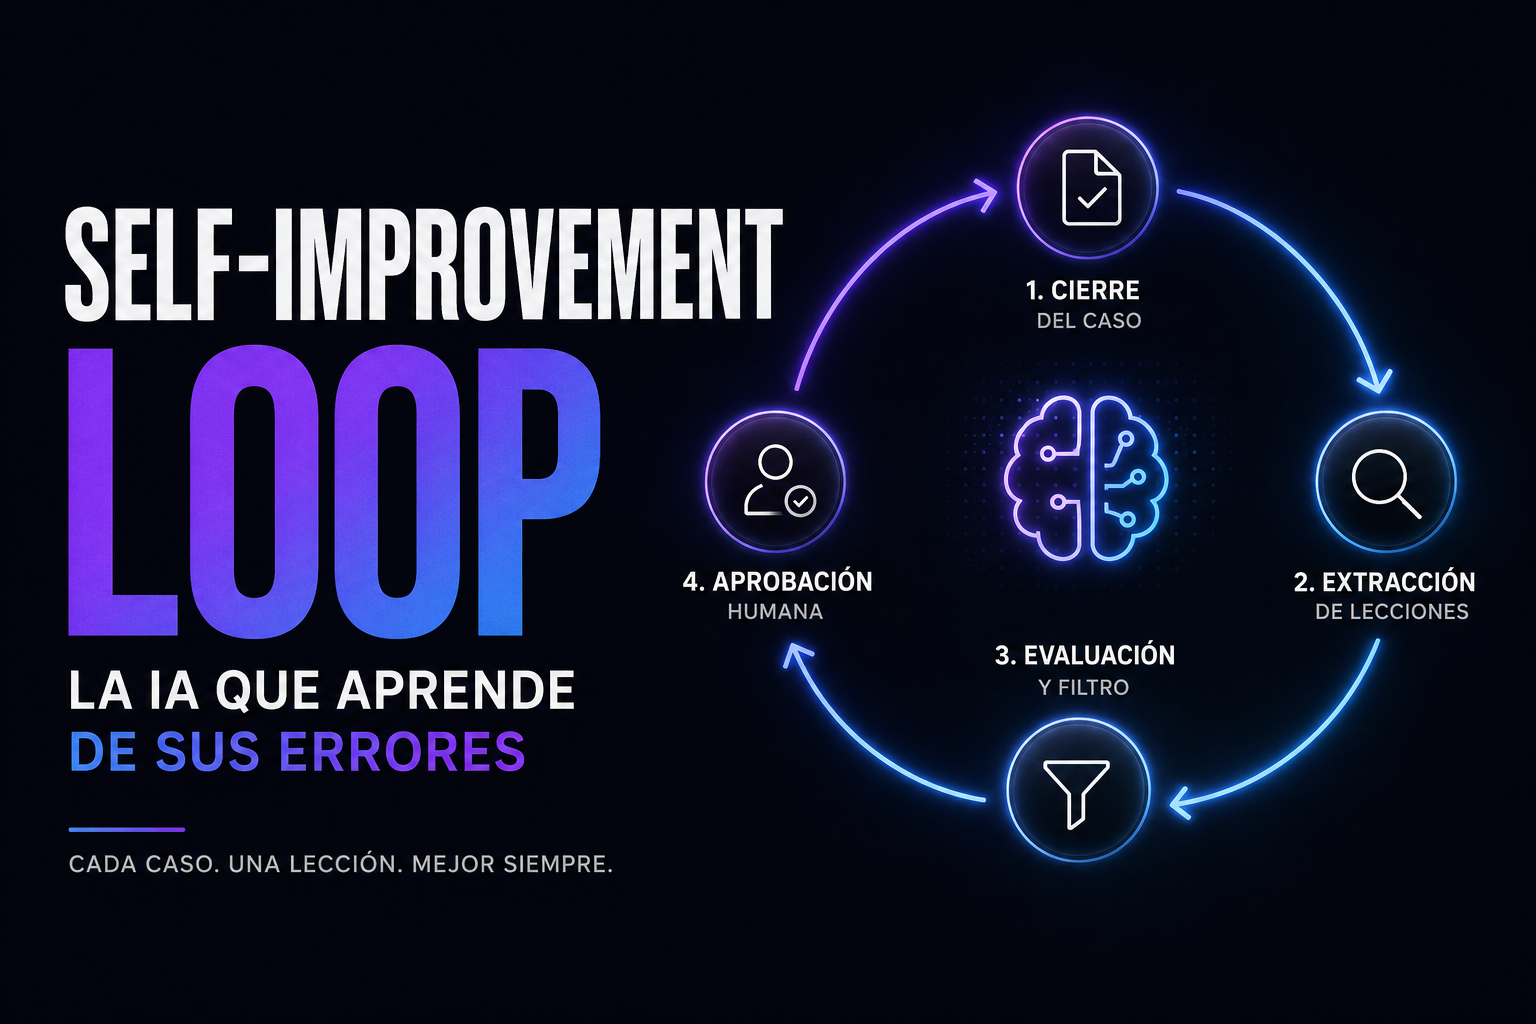
El proceso tiene cuatro pasos. Ninguno es opcional.
Paso 1: cierre del caso con retrospectiva
Cuando un caso se cierra —un contrato revisado, un informe generado, una consulta resuelta— se lanza automáticamente un comando de cierre. En el sistema que lleva más tiempo en producción de los que gestiono, ese comando es /close-case. Dispara un agente retrospectivo que analiza la sesión completa: qué instrucciones siguió el sistema, dónde funcionó bien, dónde hubo fricción, qué correcciones hizo el operador humano durante el proceso.
La retrospectiva no es una valoración subjetiva. El agente busca patrones concretos: pasos que requirieron más de una iteración, instrucciones que se malinterpretaron, contexto que faltó, excepciones que no estaban cubiertas por las reglas existentes.
Paso 2: extracción de lecciones
El agente retrospectivo genera una lista de lecciones candidatas. Una lección candidata es una observación sobre el comportamiento del sistema: «cuando el contrato tiene cláusulas de renovación automática, el agente omite verificar la ventana de rescisión». O: «la instrucción de formato para tablas de Excel no especifica qué hacer cuando hay celdas combinadas».
Estas lecciones van a un archivo de notas de sesión. Todavía no son reglas permanentes. Son observaciones en cuarentena.
Paso 3: evaluación por el curador de conocimiento
Un segundo agente —el knowledge curator— evalúa cada lección candidata contra un árbol de escalado. Este árbol tiene tres niveles de calificación:
- Nivel A — Archivo citable existe: hay un archivo específico en el sistema donde esta lección aplica. La evidencia no es vaga; hay una ruta concreta. Si la lección dice «añadir instrucción para cláusulas de renovación», debe existir un archivo de instrucciones de contratos al que añadirla.
- Nivel B — Comportamiento no cubierto: la lección aborda un caso que ninguna regla existente cubre. No es redundante. No es una variación de algo ya escrito. Es un hueco real en la guía.
- Nivel C — Patrón recurrente: la misma situación ha ocurrido al menos tres veces. No es un caso aislado. No es ruido. Es una tendencia verificable.
Para que una lección ascienda a regla permanente, debe cumplir al menos uno de los tres niveles. Si no cumple ninguno, no escala. Queda en las notas de sesión, disponible para consulta, pero no contamina el conjunto de reglas activas.
Paso 4: aprobación humana antes de aplicar
Las lecciones que superan el árbol de escalado no se aplican automáticamente. El sistema propone el cambio: qué archivo se modificaría, exactamente qué se añadiría o cambiaría, y por qué (referenciando los casos que justifican la lección). Un humano —en mi caso, yo; en el sistema de tu empresa, quien sea el responsable del sistema— revisa la propuesta y decide si aprobarla, rechazarla o modificarla.
Solo después de la aprobación el cambio se incorpora a las instrucciones permanentes del sistema.
Por qué el árbol de escalado no es opcional
Sin filtro, el archivo de lecciones se convierte en ruido en semanas. Cada caso genera observaciones. Algunas son valiosas. La mayoría son específicas de ese caso concreto y no generalizan. Si todas acaban en las reglas permanentes, el sistema empieza a tener instrucciones contradictorias, demasiado específicas para contextos que raramente vuelven a ocurrir, o simplemente redundantes.
El resultado es un sistema más confuso, no más inteligente.
El árbol de escalado resuelve esto con una pregunta simple antes de cada lección: ¿esto es suficientemente general, suficientemente nuevo y suficientemente respaldado como para merecer un lugar permanente en las instrucciones? Si la respuesta a las tres preguntas es no, la lección no escala.
En el sistema que lleva más tiempo en producción de los que gestiono, después de 37 sesiones operativas, el archivo de reglas permanentes tiene exactamente 36 entradas. Aproximadamente una regla útil por sesión. El archivo es pequeño, legible y realmente útil. Ningún operador tarda más de tres minutos en leerlo completo. Eso es la señal de que el filtro está funcionando.
El gate humano: por qué el agente propone y el humano decide
La pregunta que más recibo cuando explico este sistema es: «¿por qué no dejar que el agente aplique las mejoras solo? ¿No es más eficiente?»
Es más eficiente a corto plazo. Y es un problema a medio plazo.
Un sistema que modifica sus propias instrucciones sin supervisión humana puede derivar en direcciones que nadie detecta hasta que el daño está hecho. No porque el agente tenga malas intenciones —esa es una categoría que no aplica aquí—, sino porque cada pequeño cambio autoaplicado puede ser razonable en aislamiento y acumulativamente llevar el sistema a un comportamiento que nadie habría aprobado explícitamente.
El gate humano no es un cuello de botella burocrático. Es la diferencia entre un sistema que mejora bajo control y un sistema que evoluciona en dirección desconocida. El agente hace el trabajo pesado: analiza, extrae, evalúa, redacta la propuesta de cambio con toda la evidencia. El humano tarda dos minutos en revisar y aprobar o rechazar. El coste es mínimo. El beneficio es que el responsable del sistema siempre sabe exactamente qué reglas está siguiendo su IA y por qué.
Qué significa esto para un directivo
Si tienes o estás considerando un sistema de IA para algún departamento, la pregunta relevante no es solo «¿funciona bien al principio?». Es «¿cómo mejora con el tiempo?».
Un sistema sin bucle de mejora continua tiene un techo fijo. Funcionará igual de bien —o igual de mal— en el año dos que en el año uno. Los errores que cometió en enero los cometerá en diciembre. El conocimiento operativo que acumula el equipo que trabaja con él no se transfiere al sistema.
Un sistema con self-improvement loop diseñado correctamente tiene una curva de mejora real. Cada caso añade potencialmente una lección. Cada lección aprobada hace al sistema más preciso en ese tipo de caso. Con el tiempo, el sistema desarrolla una especialización genuina en el contexto específico de tu empresa —no en genérico, sino en tu sector, tus procesos, tus excepciones habituales.
Eso es lo que distingue una herramienta que usas de una capacidad que construyes.
Implementación práctica: los tres componentes mínimos
Para que el bucle funcione necesitas tres piezas:
- Un agente retrospectivo que analice cada caso al cerrarse. Puede ser simple: revisa la sesión, identifica desviaciones respecto a las instrucciones, genera observaciones estructuradas.
- Un curador de conocimiento que aplique el árbol de escalado a cada observación. Su única tarea es decidir si una lección candidata merece convertirse en regla permanente.
- Un proceso de aprobación humana con fricción mínima. Si revisar una propuesta de cambio tarda más de cinco minutos, el proceso se abandonará. Diseña para velocidad.
Lo que no necesitas: sistemas complejos de embeddings, bases de datos vectoriales, fine-tuning, ni nada que requiera infraestructura especializada. El bucle de mejora más efectivo que conozco vive en archivos de texto plano y comandos simples. La complejidad no es la virtud aquí.
Para profundizar en cómo gestionar el contexto que estos agentes necesitan, puedes leer cómo gestionar el contexto en agentes de inteligencia artificial. Y para entender cómo el agente crítico complementa este bucle validando la calidad antes del cierre, el artículo sobre el agente crítico de revisión en inteligencia artificial cubre ese mecanismo en detalle.
Preguntas frecuentes
¿El sistema puede cambiar sus propias reglas solo?
No. El sistema propone cambios —con evidencia, redacción exacta y justificación— pero no los aplica sin aprobación humana. El agente puede ser tan preciso como quieras en sus propuestas, pero la decisión final siempre requiere que un humano la confirme explícitamente. Esto es por diseño, no por limitación técnica.
¿Cuánto tiempo lleva configurar el bucle de mejora?
La implementación mínima funcional —agente retrospectivo básico, árbol de escalado como checklist, proceso de aprobación manual— puede estar operativa en una tarde. La sofisticación puede crecer con el tiempo: automatizar más pasos, añadir métricas de seguimiento, conectar el proceso a herramientas de gestión del conocimiento. Pero el valor empieza con la versión simple.
¿Qué pasa con las lecciones que no superan el árbol de escalado?
Quedan en el archivo de notas de sesión, accesible pero sin impacto en las instrucciones activas. Si la misma observación vuelve a aparecer en sesiones futuras, acumula evidencia hasta superar el umbral del Nivel C (patrón recurrente en 3 o más casos). El sistema tiene memoria de lo que no ha escalado todavía.
¿Funciona igual con cualquier tipo de sistema de IA?
El bucle está diseñado para sistemas basados en instrucciones explícitas —lo que en la práctica incluye la mayoría de agentes construidos con modelos de lenguaje. No aplica de la misma forma a sistemas de machine learning tradicionales donde el «conocimiento» está en los pesos del modelo, no en texto editable. Para el tipo de sistemas que construimos con Claude Code y herramientas similares, es directamente aplicable.
¿Cuánto tiempo dedica el humano que aprueba los cambios?
En el sistema con 37 sesiones mencionado antes, el tiempo promedio de revisión por lección propuesta ha sido de 90 segundos. Muchas se aprueban directamente. Algunas se rechazan o modifican. Una sesión de cierre con retrospectiva típicamente genera entre cero y dos propuestas de escalado —lo que significa entre cero y tres minutos de revisión humana por caso. Es asumible incluso para directivos con agendas densas.
Sobre Jorge Valero
Director de Tecnología e IA con más de 15 años de experiencia implantando sistemas de datos e inteligencia artificial en empresas medianas y grandes. Instructor y consultor especializado en ayudar a directivos a usar la IA como herramienta de decisión. Conoce mi trayectoria →