Obsidian + Claude Code + Cursor: el stack de un desarrollador de IA en 2026
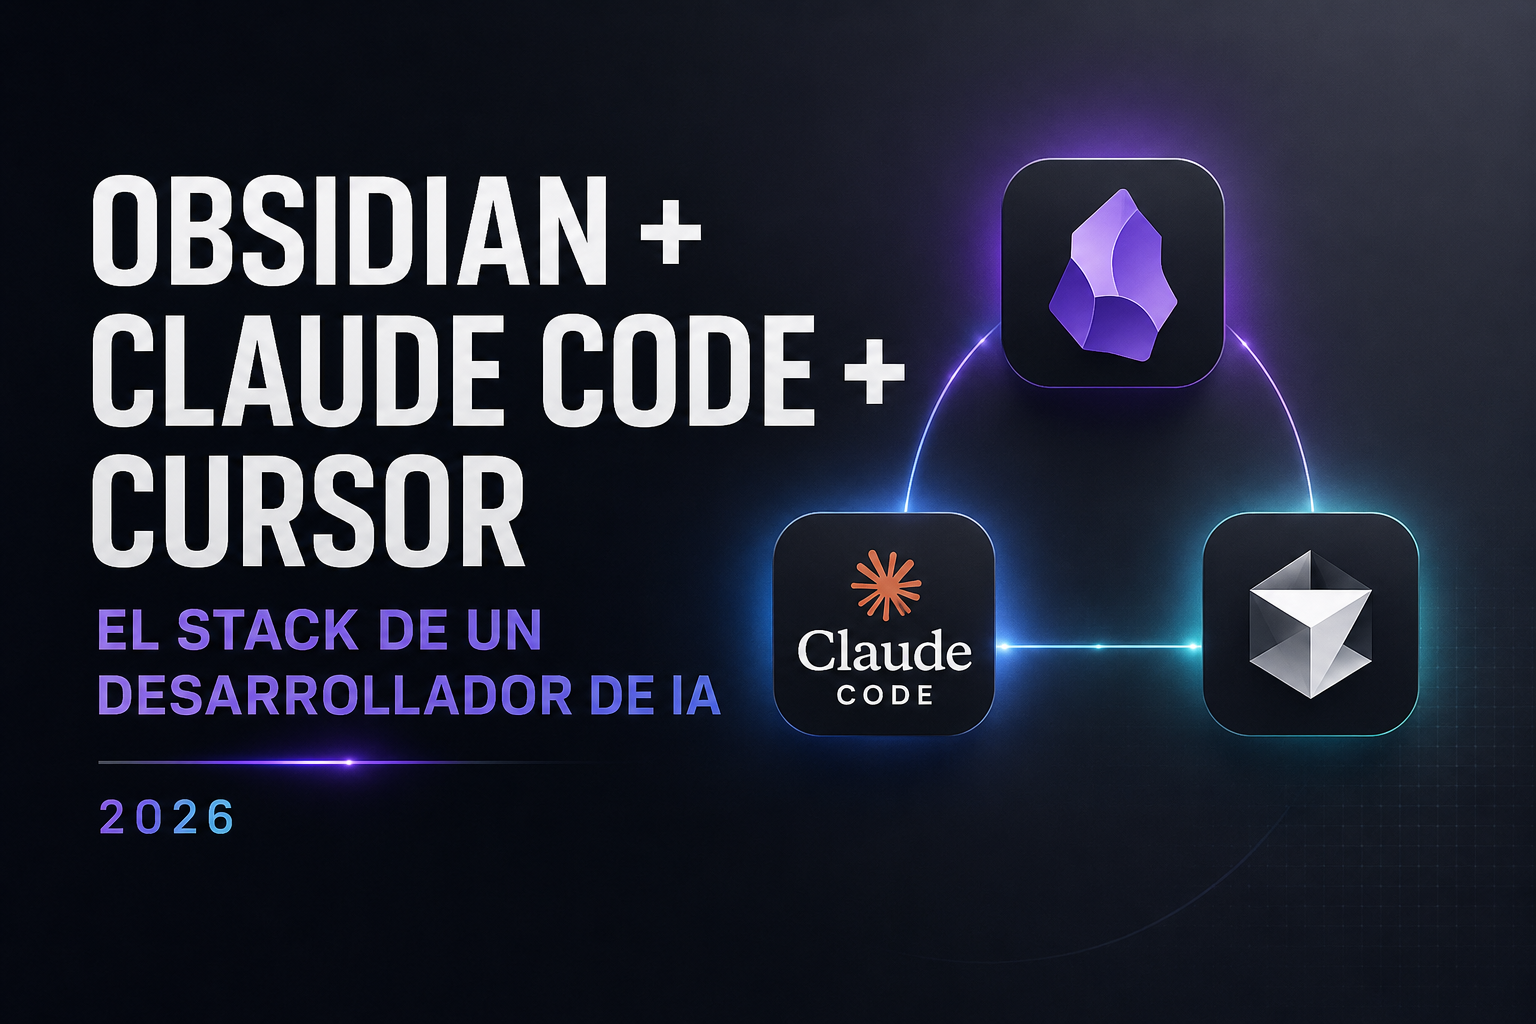
La mayoría de los desarrolladores ya tienen estas tres herramientas instaladas. Obsidian lleva abierto en una pestaña con notas de proyectos. Cursor es el editor donde escriben código todos los días. Claude Code lleva meses en el terminal. El problema no es no tenerlas: es que las usan como tres piezas separadas cuando podrían funcionar como un sistema integrado.
Este artículo documenta el setup que uso en mis propios proyectos. No es teoría. Es la arquitectura concreta que tengo corriendo en producción, con los ficheros de configuración reales y el flujo exacto que sigo cuando arranca una feature nueva. El resultado es un entorno donde el contexto no se pierde entre sesiones, las convenciones del proyecto son consistentes entre el agente y el editor, y los aprendizajes de hoy están disponibles el próximo mes.
Los tres roles: qué hace cada herramienta en el stack
Antes de hablar de integración, hay que tener claro por qué las tres son necesarias. No es maximalismo de herramientas: cada una resuelve una limitación de las otras.
Obsidian: memoria persistente del agente
Claude Code resetea contexto entre sesiones. Cada vez que abres una sesión nueva, el agente no recuerda nada de lo anterior a menos que se lo proporciones explícitamente. En proyectos largos o con múltiples desarrolladores, esto es un problema real: el agente desconoce decisiones arquitectónicas pasadas, patrones que ya se probaron y descartaron, convenciones específicas del equipo, o el historial de bugs recurrentes.
Formación presencial · Madrid
¿Quieres salir de aquí sabiendo hacer esto en tu empresa el próximo 14 de noviembre?
En un día presencial montas tus departamentos agénticos con IA y construyes tu propia app. Sin conocimientos técnicos. Máx. 16 plazas.
Obsidian resuelve exactamente esto. No es un gestor de notas genérico en este contexto: es la memoria persistente del agente. En el vault vivo almaceno: aprendizajes de sesión (qué funcionó, qué no), patrones del proyecto (convenciones de código, decisiones de arquitectura), conocimiento de empresa (stakeholders, integraciones, contratos de API), y templates reutilizables por departamento o tipo de tarea.
Con Obsidian MCP conectado, Claude Code puede leer y escribir directamente en el vault. El agente no es estúpido en la sesión 47 del proyecto porque tiene acceso a todo lo que aprendió en las 46 anteriores.
Claude Code: motor de orquestación y razonamiento
Claude Code no es un autocomplete sofisticado. Es el cerebro del sistema: razona sobre arquitectura, orquesta subagentes, gestiona contexto dentro de la sesión, y toma decisiones sobre qué hacer y en qué orden. Es donde viven las skills, los comandos personalizados, y la lógica de alto nivel del trabajo de desarrollo.
Para entender mejor cómo funcionan las skills en Claude Code, tengo un artículo detallado: Skills en Claude Code: cómo configurar capacidades específicas para tus agentes.
Cursor: editor con contexto de IA para implementación
Cursor es mejor que Claude Code para edición intensiva dentro de ficheros. Cuando hay que implementar funcionalidad concreta — modificar 15 ficheros, refactorizar una clase compleja, seguir las convenciones exactas del codebase — Cursor con su contexto de codebase es más eficiente. Lee el proyecto completo, entiende imports y dependencias, y genera código que encaja con lo que ya existe.
La limitación de Cursor es que no orquesta, no tiene memoria persistente, y no razona bien sobre decisiones de alto nivel. Por eso necesita a Claude Code como complemento, no como sustituto.
Cómo se conectan las tres herramientas
Conexión 1: Obsidian → Claude Code vía MCP
La conexión más importante del stack. Obsidian MCP permite a Claude Code consultar el vault como si fuera una base de conocimiento estructurada. La configuración va en el fichero .mcp.json de tu proyecto, especificando el servidor MCP de Obsidian y la ruta al vault. En el curso lo configuramos paso a paso para cada setup concreto.
Con esto activo, en cualquier sesión de Claude Code puedo pedir cosas como: «¿Qué aprendimos sobre el manejo de errores en el flujo de pagos?» y el agente buscará en el vault en lugar de inventarse una respuesta o pedirme que le proporcione contexto.
La clave está en cómo estructuro el vault. No es un cajón de notas: es una base de conocimiento con carpetas específicas por proyecto, tipo de aprendizaje, y relevancia temporal. Las notas de patrones del proyecto están en proyectos/nombre-proyecto/patrones/, los aprendizajes de sesión en proyectos/nombre-proyecto/sesiones/YYYY-MM-DD.md, y el conocimiento de empresa en empresa/.
Conexión 2: Claude Code → Cursor vía .cursorrules
El CLAUDE.md del proyecto y el fichero .cursorrules de Cursor deben estar sincronizados. Son el mismo conocimiento expresado para dos consumidores distintos: Claude Code y Cursor respectivamente. Si no los sincronizas, tienes al agente siguiendo convenciones distintas a las del editor, y el código generado por cada uno choca.
Mi flujo es simple: CLAUDE.md es la fuente de verdad. Cada vez que actualizo las convenciones del proyecto en CLAUDE.md, genero o actualizo el .cursorrules con el subconjunto relevante para el editor. El .cursorrules es más conciso que el CLAUDE.md: contiene stack tecnológico, convenciones de nombrado, patrones de código y las restricciones más importantes. Todo lo que Cursor necesita para generar código que encaje con lo que ya existe en el proyecto.
El contenido concreto de un .cursorrules bien construido depende del proyecto: lenguaje, framework, arquitectura, patrones de equipo. En el curso trabajamos la sincronización CLAUDE.md ↔ .cursorrules directamente sobre los proyectos de cada participante.
Cuando Cursor lee esto, genera código consistente con lo que Claude Code entiende del proyecto. No hay dos mundos paralelos: hay un sistema coherente.
Conexión 3: Claude Code → Obsidian (escritura de aprendizajes)
Al final de cada sesión relevante, Claude Code escribe los aprendizajes de vuelta al vault. Esto lo tengo como un comando slash personalizado en mi setup: /close-session. Cuando lo ejecuto, el agente genera una nota de sesión con el formato estándar y la escribe en Obsidian vía MCP.
El formato de nota tiene secciones fijas: contexto de la sesión, decisiones tomadas y por qué, patrones identificados, problemas encontrados con su solución, y notas para la próxima sesión. Lo que hace útil ese formato no es la estructura en sí — es que el agente la rellena de forma consistente, sesión tras sesión, sin que tú tengas que hacerlo manualmente.
Este ciclo de escritura convierte la memoria efímera de la sesión en conocimiento persistente del sistema.
El flujo completo: de feature request a código en producción
Para concretar cómo funciona el stack en la práctica, puedo describir la lógica general del flujo cuando llega una nueva feature. No voy a entrar en cada paso con detalle —eso es exactamente lo que cubro en el curso presencial— pero la estructura es esta:
Antes de escribir código, Claude Code consulta el vault para recuperar el contexto relevante: decisiones arquitectónicas, patrones establecidos, aprendizajes de features similares. Si ya construimos algo parecido, el agente lo sabe desde el principio.
Con ese contexto, Claude Code genera la especificación: plan por capas, estructura de ficheros, tests necesarios, riesgos identificados. Ahí es donde el razonamiento de alto nivel importa.
La implementación pesada ocurre en Cursor, que entiende el codebase y sigue las convenciones del .cursorrules. Claude Code vuelve para la revisión: arquitectura, seguridad, tests pendientes.
Al cerrar la sesión, los aprendizajes quedan en Obsidian. La próxima vez que se construya algo similar, el contexto está disponible desde el minuto uno.
El valor del stack no está en ninguno de esos pasos por separado. Está en que son un sistema: cada herramienta hace lo que mejor sabe, y el conocimiento fluye entre las tres sin perderse.
Si quieres ver la construcción de este tipo de agentes desde cero, explico el proceso completo en: Cómo construir tu primer agente con Claude Code paso a paso.
Por qué este stack y no solo Claude Code
La pregunta válida es: ¿por qué no usar solo Claude Code con un contexto muy largo? Tres razones concretas:
Persistencia real vs. contexto extendido. Incluso con ventanas de contexto grandes, cargar todo el historial del proyecto en cada sesión es costoso (en tokens y en tiempo) e impreciso. Obsidian permite recuperación selectiva: el agente consulta solo lo relevante para la tarea actual, no todo el historial desde el inicio del proyecto.
Edición de ficheros pesada. Claude Code es bueno orquestando y razonando. Cursor es mejor editando: tiene indexación del codebase, jump to definition, refactors automáticos informados por el grafo de dependencias. Para implementación intensiva, Cursor con contexto de codebase produce menos errores de integración.
Conocimiento compartido en equipos. Cuando el vault de Obsidian está en un repositorio compartido (o sincronizado vía Obsidian Sync), todos los desarrolladores del equipo tienen acceso al mismo conocimiento acumulado. No hay silos de contexto por persona: hay una memoria del equipo que cada agente puede consultar.
Preguntas frecuentes
¿Obsidian MCP requiere instalar un servidor aparte?
No en la configuración que uso. El paquete obsidian-mcp de npm actúa como servidor MCP ligero que se lanza on-demand cuando Claude Code lo necesita. No hay proceso permanente corriendo. La configuración en .mcp.json especifica el vault path y Claude Code gestiona el ciclo de vida del servidor automáticamente. El único requisito previo es tener el vault de Obsidian accesible en el sistema de ficheros local (no funciona con vault en móvil únicamente).
¿Qué pasa cuando el vault crece mucho? ¿Afecta al rendimiento?
El MCP no carga el vault completo en contexto: hace búsqueda semántica o por keywords sobre las notas. Con vaults de hasta 2.000-3.000 notas el rendimiento es bueno. Para proyectos más grandes, la estructura de carpetas importa: mantener separadas las notas activas de las archivadas mejora la relevancia de los resultados. También ayuda usar frontmatter con tags en las notas para que las búsquedas del agente sean más precisas.
¿El fichero .cursorrules tiene que ser idéntico al CLAUDE.md?
No idéntico: es un subconjunto. CLAUDE.md puede contener contexto de arquitectura, decisiones de producto, y razonamiento que es útil para un agente de orquestación pero irrelevante para un editor de código. El .cursorrules debe contener lo que Cursor necesita para generar código consistente: stack tecnológico, convenciones de nombrado, patrones de código, y las restricciones más importantes («sin lógica en controllers», «siempre validar con Zod»). Mantengo el .cursorrules más conciso que el CLAUDE.md, alrededor de 80-120 líneas.
¿Funciona este stack en equipos donde no todos usan Claude Code?
Sí, con ajustes. El vault de Obsidian funciona como base de conocimiento del proyecto independientemente de quién lo consulte — un desarrollador puede abrirlo directamente en Obsidian sin usar el agente. El .cursorrules aplica para cualquiera en el equipo que use Cursor. La parte que requiere Claude Code es la escritura automática de aprendizajes y la consulta via MCP; el resto del valor (memoria estructurada, convenciones consistentes) lo obtiene cualquier miembro del equipo. He visto equipos adoptarlo de forma gradual: primero el vault y el .cursorrules, luego Claude Code para los miembros más avanzados.
¿Hay alternativas a Obsidian para la parte de memoria persistente?
Hay alternativas, pero Obsidian tiene ventajas específicas para este uso. Primero, los ficheros son Markdown plano en disco: no hay lock-in, el vault es un directorio que puedes versionar con git. Segundo, el ecosistema de plugins y el soporte de Dataview permiten estructurar el conocimiento de formas que herramientas como Notion o Confluence no facilitan para consumo por agentes. Tercero, la integración MCP con Obsidian está madura y bien mantenida. Si tu equipo ya usa Notion, existe un MCP de Notion que cubre casos de uso similares, aunque con menos control sobre la estructura de las notas.
Estado actual del stack y evolución esperada
Este stack lleva estable varios meses en producción. Los puntos que más he ajustado desde la versión inicial: la granularidad de las notas de sesión (empecé con notas muy detalladas y terminé en formatos más compactos), la frecuencia de sincronización del .cursorrules (ahora lo actualizo como parte del proceso de merge, no ad-hoc), y la estructura de carpetas del vault (más separación entre conocimiento activo y archivado).
Lo que veo evolucionando en 2026-2027: integración más profunda entre herramientas (probablemente Claude Code leerá directamente configuración de Cursor en lugar de necesitar sincronización manual), y vaults de equipo con control de acceso granular para grandes organizaciones. La dirección es clara: el contexto del desarrollador dejará de vivir en su cabeza o en ficheros dispersos y pasará a ser una capa de infraestructura del equipo de desarrollo.
El stack que describo aquí no es la versión final de ninguna de las tres herramientas. Es la mejor integración disponible hoy con las capacidades actuales. Merece la pena invertir en configurarlo bien porque la curva de adopción de la siguiente versión será mucho más suave si ya tienes la arquitectura de memoria y convenciones en su sitio.
Sobre Jorge Valero
Director de Tecnología e IA con más de 15 años de experiencia implantando sistemas de datos e inteligencia artificial en empresas medianas y grandes. Instructor y consultor especializado en ayudar a directivos a usar la IA como herramienta de decisión. Conoce mi trayectoria →