Cómo los agentes gestionan el contexto (y por qué sin gestión el sistema se degrada)
El primer sistema que vimos degradarse por context bloat llevaba tres semanas en producción. Era un agente de análisis de contratos. Funcionaba bien. Todos los días bien. Y luego, sin cambiar nada en el código, empezó a devolver respuestas más cortas, a omitir secciones que antes incluía, a ignorar instrucciones que seguía sin problema. El equipo buscó el bug durante dos días. No había bug. El problema era el contexto.
Este artículo explica qué es el context bloat, por qué es un problema silencioso y peligroso, y cómo una arquitectura de cuatro capas previene la degradación antes de que ocurra. Si gestionas agentes en producción o estás a punto de hacerlo, es el problema que nadie te advierte hasta que lo sufres.
Qué es el context bloat y por qué degrada el sistema
Los agentes de inteligencia artificial operan sobre una ventana de contexto: el bloque de texto que el modelo recibe como entrada en cada llamada. En esa ventana va todo: las instrucciones del sistema, el historial de la sesión, los documentos cargados, los resultados de herramientas anteriores y el mensaje actual del usuario. Lo que traen los servidores MCP también gasta contexto, así que cuenta. Los comandos de Claude Code ayudan a vigilar y recortar el contexto.
El problema no es que la ventana sea pequeña. Los modelos actuales soportan ventanas de 200.000 tokens o más. El problema es que cuanto más llena está la ventana, más se diluye la atención del modelo. Las instrucciones que estaban al principio compiten por relevancia con todo lo que se ha acumulado después. El agente empieza a «olvidar» sus propias reglas sin que nadie haya cambiado nada.
Formación presencial · Madrid
¿Quieres salir de aquí sabiendo hacer esto en tu empresa el próximo 14 de noviembre?
En un día presencial montas tus departamentos agénticos con IA y construyes tu propia app. Sin conocimientos técnicos. Máx. 16 plazas.
A eso se le llama context bloat: la acumulación progresiva de tokens que no son necesarios para la tarea actual pero que siguen presentes en la ventana, aumentando el coste por llamada y degradando la calidad de las respuestas.
Lo que lo hace especialmente traicionero es que es un problema silencioso. El agente no falla de forma obvia. No lanza un error. Sigue respondiendo, sigue procesando. Simplemente lo hace peor. Y peor. Y peor. Hasta que alguien en el equipo lo nota y ya llevan semanas con el sistema degradado en producción.
En un sistema sin gestión de contexto, el overhead por sesión puede superar los 3.000 tokens de ruido acumulado. Con una arquitectura de cuatro capas bien diseñada, ese número baja a ~978 tokens. Una reducción del 70% que además estabiliza la calidad de las respuestas a lo largo del tiempo.

La arquitectura de cuatro capas para gestionar el contexto
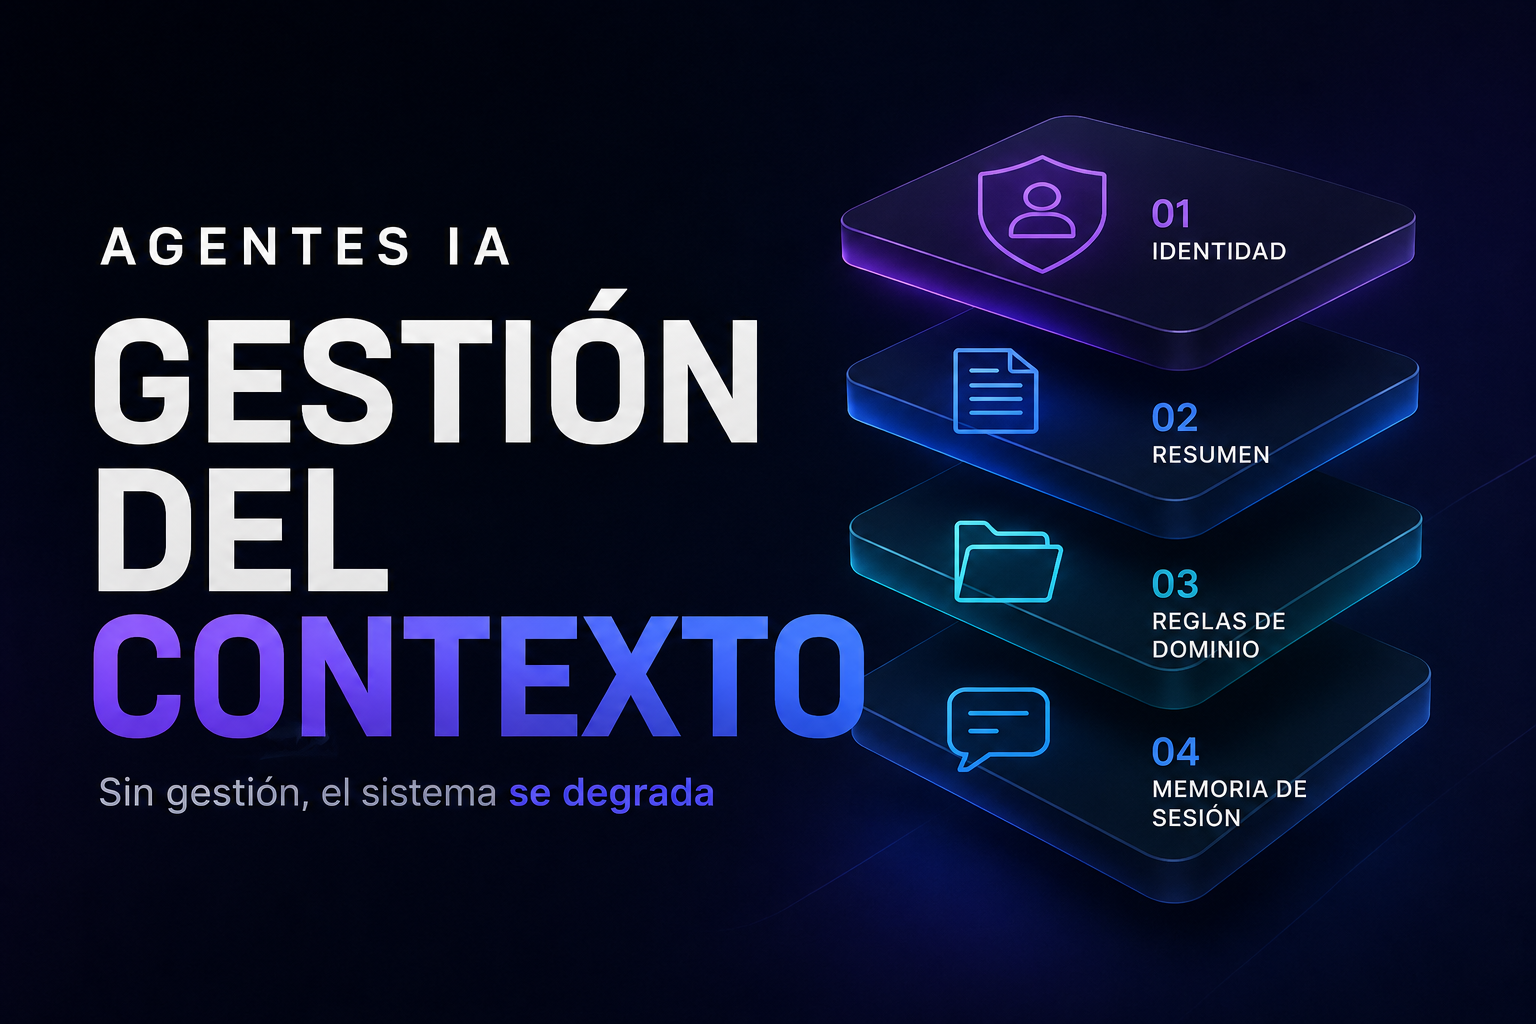
La solución no es comprimir todo al principio ni cargar solo lo mínimo posible. Es estructurar el conocimiento del agente en capas con reglas distintas de carga y vida útil. Cada capa tiene una función específica. Ninguna hace lo que hace otra.
┌─────────────────────────────────────────────────────┐
│  CAPA 1 — Identidad del agente (CLAUDE.md)          │
│  Siempre cargada · Mantenida compacta · Inmutable   │
├─────────────────────────────────────────────────────┤
│  CAPA 2 — Resumen del proyecto (symlink)            │
│  Auto-carga via .claude/CLAUDE.md → resumen.md      │
│  Se actualiza entre sesiones · Sin intervención     │
├─────────────────────────────────────────────────────┤
│  CAPA 3 — Reglas de dominio (bajo demanda)          │
│  Cargadas solo cuando la tarea las necesita         │
│  No activas por defecto · Cero overhead en reposo   │
├─────────────────────────────────────────────────────┤
│  CAPA 4 — Memoria de sesión (efímera)               │
│  Contexto específico de esta sesión                 │
│  Se descarta al terminar · No persiste              │
└─────────────────────────────────────────────────────┘
Capa 1: CLAUDE.md — la identidad del agente
El CLAUDE.md es el archivo que Claude Code carga automáticamente en cada sesión. Es la capa que siempre está presente. Define quién es el agente: su propósito, sus restricciones, sus principios de comportamiento y los patrones que debe seguir sin excepción.
La regla de esta capa es mantenerla compacta. No es donde va el conocimiento del proyecto. No es donde van las reglas de dominio. Es donde va lo que el agente necesita saber en cualquier contexto, independientemente de la tarea. Si algo puede estar en otra capa, no debe estar aquí.
Un CLAUDE.md bien diseñado tiene entre 300 y 600 tokens. Uno mal diseñado tiene 5.000 tokens y contiene cosas que el agente solo necesita en el 10% de las sesiones. Ese 90% restante es context bloat garantizado.
Capa 2: el resumen vía symlink
Esta es la capa que más sorprende a los equipos cuando la ven por primera vez. Es un truco de filesystem que no cuesta nada y resuelve un problema real.
El problema es este: el estado del proyecto cambia. Las decisiones tomadas en sesiones anteriores, los archivos relevantes, las convenciones adoptadas, la arquitectura actual — todo evoluciona. Pero si metes toda esa información en el CLAUDE.md, la Capa 1 se infla. Y si no la metes, el agente empieza cada sesión sin memoria del proyecto.
La solución es un symlink: .claude/CLAUDE.md apunta a contexto/resumen.md. El archivo resumen.md es el que se actualiza después de cada sesión con el estado actual del proyecto. El symlink hace que ese resumen se cargue automáticamente como si fuera el CLAUDE.md, sin que nadie tenga que hacer nada manualmente.
# Crear el symlink (una sola vez)
ln -s ../contexto/resumen.md .claude/CLAUDE.md
Resultado: el agente siempre tiene el contexto actualizado del proyecto sin que el equipo tenga que mantener dos archivos. El overhead es cero. Es la mejora con mejor ratio coste-beneficio de toda la arquitectura.
Capa 3: reglas de dominio bajo demanda
Las reglas de dominio son el conocimiento especializado que el agente necesita solo en ciertos contextos. Las reglas de revisión de seguridad OWASP. Los patrones de clean architecture. Las convenciones específicas de una base de código. Las restricciones legales de un sector.
El error habitual es cargar todas estas reglas siempre, «por si acaso». El resultado es una ventana de contexto llena de instrucciones que el 80% del tiempo no son relevantes para la tarea actual.
En la arquitectura de cuatro capas, estas reglas viven en archivos separados dentro de .claude/reglas/. Se cargan explícitamente solo cuando la tarea las necesita. Un agente que está redactando copy de marketing no necesita cargar las reglas de revisión SQL. Un agente que está revisando un schema de base de datos no necesita las reglas de formato de contenido.
La carga bajo demanda mantiene el overhead de contexto mínimo durante las tareas más frecuentes y permite que las tareas especializadas tengan toda la información necesaria sin contaminar el resto de sesiones.
Capa 4: memoria de sesión efímera
La cuarta capa es el contexto específico de la sesión actual. Decisiones tomadas en esta sesión, archivos procesados, resultados intermedios, el hilo de razonamiento que el agente ha construido durante el trabajo de hoy.
La regla de esta capa es que no persiste. Cuando la sesión termina, este contexto se descarta. No se intenta guardar todo — eso sería acumular ruido. Lo que vale la pena conservar de esta sesión pasa a la Capa 2 durante el proceso de compresión post-sesión.
La distinción entre «lo que importa de esta sesión» y «el ruido de esta sesión» es exactamente lo que hace la extracción de invariantes antes de comprimir.
Cuándo comprimir: después, no antes
El instinto de muchos equipos cuando implementan gestión de contexto es comprimir al inicio de la sesión. La lógica parece razonable: reducir el contexto antes de empezar para que la ventana no se llene.
El problema es que al inicio de la sesión no sabes qué vas a necesitar. Comprimir antes significa potencialmente eliminar información que luego será crítica. Es como tirar papeles de tu escritorio antes de una reunión sin saber de qué va a tratar la reunión.
La compresión correcta ocurre al final de la sesión, cuando ya sabes qué fue importante. Solo entonces puedes distinguir entre el contexto que tiene valor para sesiones futuras y el ruido que no necesita persistir.
Extracción de invariantes antes de comprimir
Antes de comprimir el resumen de una sesión, hay un paso que no se puede saltar: extraer los invariantes. Son los elementos que si cambian entre sesiones sin que nadie lo haya decidido conscientemente, rompen el sistema.
Los invariantes incluyen:
- Términos en MAYÚSCULAS con significado específico en el proyecto (convenciones, roles, estados)
- Términos en
códigoque identifican archivos, funciones o configuraciones - Números de versión de dependencias críticas
- Rutas de archivos que otros procesos esperan encontrar en esa ubicación exacta
- Nombres de configuraciones con parámetros específicos
El proceso es extraer estos invariantes, listarlos explícitamente, y verificar que están presentes en el resumen comprimido antes de sobrescribir el original. Si alguno falta, el sistema no usa el resumen comprimido — restaura el original.
Este rollback automático es lo que hace la arquitectura resiliente. No depende de que la compresión salga perfecta cada vez. Depende de que el sistema pueda detectar cuándo la compresión elimina algo que no debería haberse eliminado.
Métricas reales: el coste del context bloat
Estos números vienen de sistemas que hemos monitoreado en producción. No son teóricos.
| Métrica | Sin gestión | Con 4 capas | Reducción |
|---|---|---|---|
| Overhead de contexto por sesión | ~3.200 tokens | ~978 tokens | 70% |
| Degradación de calidad a 30 días | Notable | Estable | — |
| Coste de tokens por tarea equivalente | Base | ~30% menor | 30% |
| Sesiones antes de intervención manual | ~15-20 | Indefinido | — |
La columna que más me interesa cuando audito un sistema es la última: cuántas sesiones pueden ocurrir antes de que alguien del equipo tenga que intervenir para «limpiar» el contexto manualmente. En sistemas sin gestión, esa intervención suele ocurrir cada dos o tres semanas. En sistemas con la arquitectura de cuatro capas, no hace falta.
Si quieres entender cómo el context bloat afecta al coste total de operar agentes, el artículo sobre coste de agentes de inteligencia artificial en producción entra en el detalle de cómo calcular y controlar ese coste.
El problema de fondo: no es un bug, es un diseño
El context bloat no es un fallo del modelo. Es una consecuencia directa de cómo está diseñado el sistema que lo rodea. Los modelos de lenguaje funcionan exactamente como están diseñados. El problema es que la mayoría de los sistemas que se construyen alrededor de ellos no han pensado en la gestión del contexto como una decisión de arquitectura.
La diferencia entre un sistema que funciona bien durante tres semanas y uno que funciona bien durante años no está en el modelo que usan. Está en cómo gestionan el conocimiento que ese modelo necesita para operar.
Las cuatro capas no son una solución mágica. Son una forma de externalizar el problema: en lugar de dejar que el contexto crezca de forma orgánica hasta que se convierte en un problema, defines desde el principio qué tipo de conocimiento va en cada capa y cuáles son las reglas de vida útil de cada una.
Si estás construyendo skills y agentes especializados para tu organización, la arquitectura de cómo se cargan y se gestionan esas skills es exactamente el nivel de diseño en el que ocurre la diferencia. El artículo sobre skills en Claude Code cubre cómo se estructura ese nivel.
Checklist de implementación
Si quieres aplicar la arquitectura de cuatro capas a un sistema existente, estos son los pasos en orden:
- Audita tu CLAUDE.md actual. ¿Tiene más de 600 tokens? ¿Hay instrucciones que solo son relevantes en el 20% de las sesiones? Muévelas a Capa 3.
- Crea la estructura de carpetas.
contexto/resumen.mdpara el estado del proyecto,.claude/reglas/para el conocimiento de dominio. - Crea el symlink.
ln -s ../contexto/resumen.md .claude/CLAUDE.md. Verifica que se carga correctamente en la siguiente sesión. - Identifica tus reglas de dominio. ¿Qué conocimiento especializado carga el agente siempre aunque no lo necesite? Muévelo a archivos separados en
.claude/reglas/. - Define el proceso de compresión post-sesión. Al final de cada sesión: extrae invariantes, comprime el resumen, verifica que los invariantes están presentes, actualiza
contexto/resumen.md. - Mide el overhead antes y después. Cuántos tokens de contexto por sesión antes de la arquitectura, cuántos después. Ese número te dice si la implementación está funcionando.
Preguntas frecuentes sobre gestión de contexto en agentes
¿La ventana de 200.000 tokens de los modelos actuales no hace irrelevante el context bloat?
No. El context bloat no es un problema de límite de ventana — es un problema de calidad dentro de la ventana. Cuando la ventana está muy cargada, las instrucciones que están al principio compiten con todo lo que se ha acumulado después. El modelo sigue respondiendo, pero la atención se distribuye peor. El límite alto de los modelos actuales oculta el problema durante más tiempo, pero no lo elimina.
¿El symlink funciona en cualquier sistema operativo?
En Linux y macOS, sí, sin ninguna consideración especial. En Windows, los symlinks requieren activar el modo desarrollador o ejecutar el comando con privilegios de administrador. Para equipos que trabajan en Windows, la alternativa es un script de sincronización que copia el contenido de resumen.md a .claude/CLAUDE.md al inicio de cada sesión, aunque esto requiere un paso manual que el symlink elimina.
¿Con qué frecuencia hay que actualizar el resumen de la Capa 2?
La regla práctica es: actualiza el resumen cuando la sesión ha generado decisiones que afectan a sesiones futuras. No todas las sesiones lo hacen. Una sesión de análisis rutinario no necesita actualizar el resumen. Una sesión donde se decidió cambiar la arquitectura de datos, adoptar una nueva convención de nombres o incorporar una nueva dependencia, sí. El criterio es si un agente que empieza mañana sin leer el resumen actualizado tomaría decisiones distintas o incorrectas.
¿Qué pasa si el sistema de rollback falla y se usa un resumen corrupto?
La consecuencia más común es que el agente empiece la sesión con comportamiento inconsistente: ignora reglas que antes seguía o aplica convenciones que ya no son válidas. La forma de detectarlo rápido es tener un test de coherencia al inicio de la sesión: el agente verifica que puede responder correctamente a tres o cuatro preguntas básicas sobre el proyecto antes de empezar a trabajar. Si falla alguna, la sesión se detiene y se restaura el resumen original antes de continuar.
¿Esta arquitectura es específica de Claude Code o se puede aplicar a otros sistemas?
Los principios son transferibles a cualquier sistema agéntico: el concepto de capas de conocimiento con distintas reglas de vida útil, la separación entre contexto permanente y contexto efímero, la compresión post-sesión con extracción de invariantes. La implementación específica (el symlink a .claude/CLAUDE.md, la estructura de carpetas) es específica de Claude Code. En otros sistemas, los mecanismos concretos varían, pero la arquitectura subyacente aplica igual.
Sobre Jorge Valero
Director de Tecnología e IA con más de 15 años de experiencia implantando sistemas de datos e inteligencia artificial en empresas medianas y grandes. Instructor y consultor especializado en ayudar a directivos a usar la IA como herramienta de decisión. Conoce mi trayectoria →