Comandos en Claude Code: cómo automatizar flujos completos de trabajo
Hay un problema que aparece en casi todos los proyectos de automatización que alcanzan cierta madurez. En demo, el flujo funciona. El agente coge la tarea, la procesa, produce un output. Todo el mundo asiente en la sala. El equipo queda satisfecho. Pasan seis semanas y el sistema está en producción. Nadie sabe exactamente qué está haciendo en cada momento. No hay registro de qué decisiones tomó qué agente. Cuando algo falla, no hay forma de trazar el problema hasta su origen. El director de tecnología pregunta «¿en qué punto del flujo estamos?» y la respuesta honesta es: no lo sabemos con precisión.
Ese fue el tercer proyecto que vi fallar por falta de trazabilidad. No por falta de inteligencia en los agentes. No por limitaciones del modelo. Por falta de estructura en el ciclo de vida del trabajo. Y fue ese tercer proyecto el que me llevó a diseñar un ciclo de comandos que hoy corre en producción y que es el núcleo de este artículo. Cuando un comando necesita datos de otra herramienta, lo resuelve un servidor MCP. Un comando bien hecho puede lanzar a un agente crítico que revise el resultado antes de que lo veas.
Comandos vs skills: una distinción que importa
Antes de entrar en el ciclo, necesito aclarar una distinción que genera confusión con frecuencia: la diferencia entre un comando y una skill en Claude Code.
Una skill es una capacidad especializada. Es una herramienta que el agente puede invocar. Un skill de revisión de seguridad, un skill de generación de tests, un skill de análisis STRIDE. Las skills son componentes verticales: hacen una cosa concreta y la hacen bien. Cuando diseñas una skill, piensas en qué capacidad específica necesita el agente en un momento dado.
Formación presencial · Madrid
¿Quieres salir de aquí sabiendo hacer esto en tu empresa el próximo 14 de noviembre?
En un día presencial montas tus departamentos agénticos con IA y construyes tu propia app. Sin conocimientos técnicos. Máx. 16 plazas.
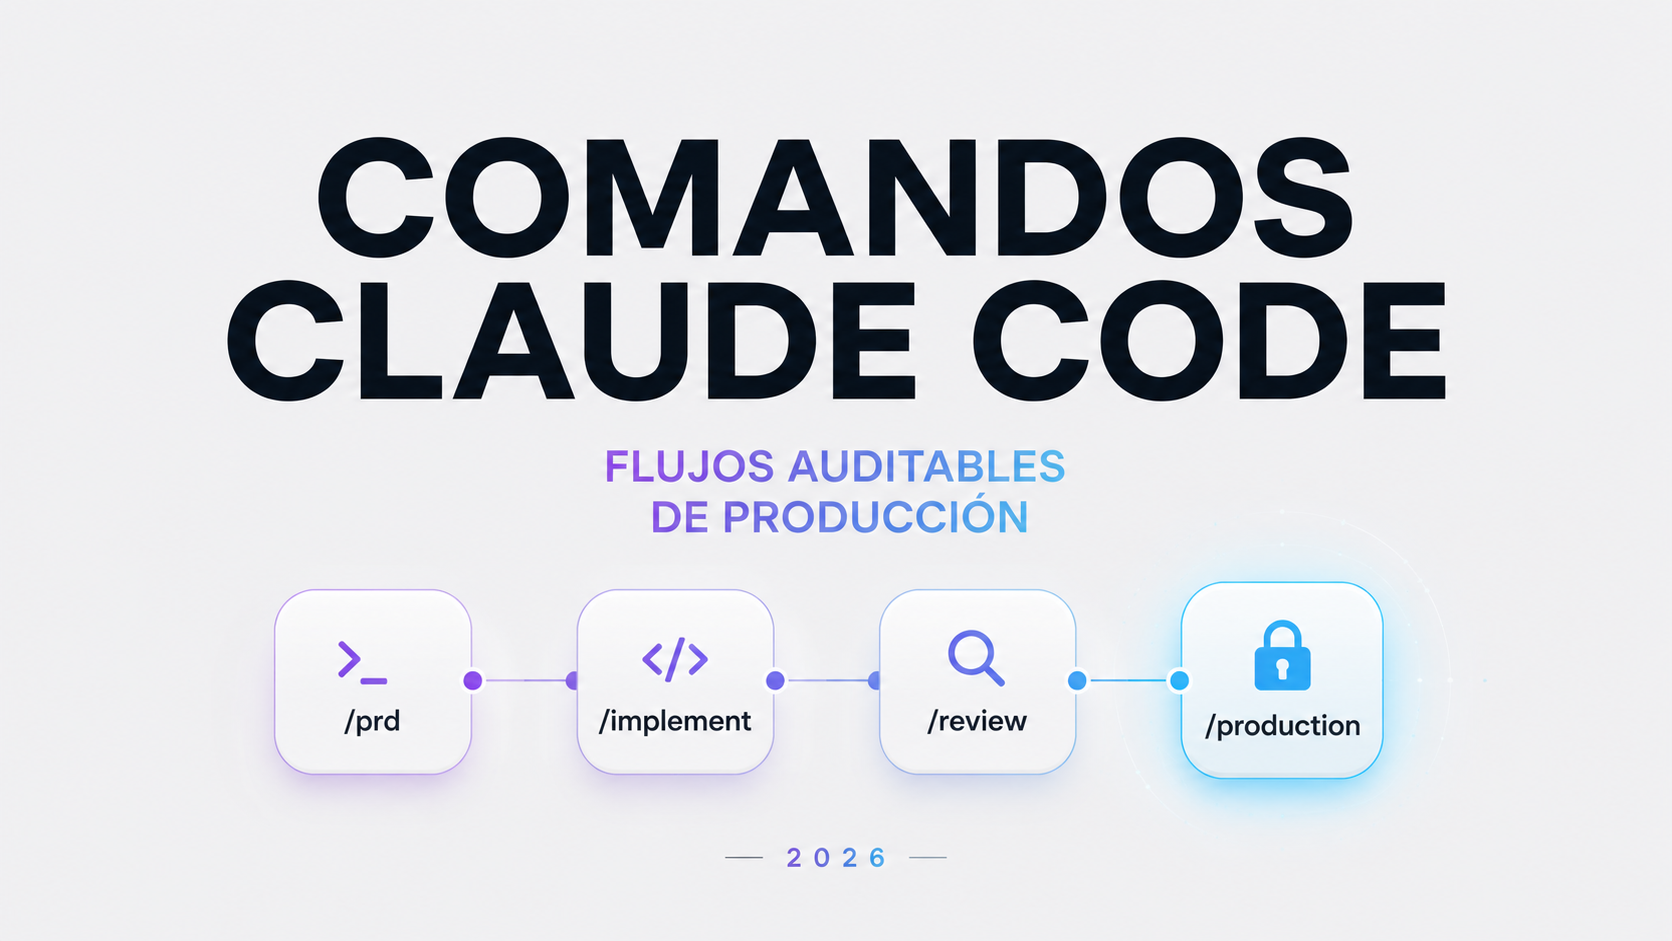
Un comando es una etapa del ciclo de vida del proyecto. Es un punto de control en el flujo de trabajo. /prd, /implement, /qa, /production. Los comandos son componentes horizontales: orquestan qué agentes se activan, qué artefactos se generan, qué condiciones deben cumplirse para avanzar. Cuando diseñas un comando, piensas en qué tiene que ocurrir para que el proyecto pase de un estado al siguiente.
La confusión es comprensible porque en la práctica un comando puede invocar múltiples skills. /review activa el agente critic, que usa el skill de análisis de código, el skill de verificación de cobertura de tests y el skill de comprobación de criterios de aceptación. El comando es el paso del proceso. Las skills son las herramientas que se usan en ese paso.
Esta distinción no es académica. Si no tienes comandos —solo skills— tienes capacidades sin estructura de ciclo de vida. Tienes herramientas sin proceso. Y en producción, un conjunto de herramientas sin proceso es exactamente tan caótico como suena.
El ciclo de 14 comandos
El ciclo que diseñamos después de ese tercer proyecto fallido tiene catorce comandos. Trece para el flujo estándar y uno para cierres inesperados. Cada comando activa agentes específicos, genera artefactos concretos y deja una puerta que debe abrirse antes de que el siguiente comando pueda ejecutarse.
| # | Comando | Qué hace | Artefacto generado |
|---|---|---|---|
| 01 | /new-application | Inicializa el caso. Crea la estructura de carpetas, asigna ID único, registra solicitante y fecha. | case.json |
| 02 | /discover | Agente explorador analiza la base de código existente. Mapea dependencias, identifica patrones en uso, detecta conflictos potenciales. | discovery.md |
| 03 | /prd | Agente de producto genera el PRD completo. Requisitos funcionales y no funcionales, criterios de aceptación, scope explícito. | prd.md |
| 04 | /stories | Lee prd.md y descompone en historias de usuario con IDs trazables a cada requisito del PRD. | stories.md |
| 05 | /plan | Agente de arquitectura diseña la solución técnica. Lee discovery.md y stories.md. Decisiones de capas, interfaces, dependencias. | architecture.md |
| 06 | /spec | Especificación técnica detallada por historia. Contracts de API, esquemas de datos, casos de test esperados. | specs/[story-id].md |
| 07 | /implement | Agente de implementación escribe el código. Lee la spec de la historia activa. Commit con referencia al story ID. | código + commits |
| 08 | /review | Agente critic revisa el código. Analiza coherencia con spec, cobertura de tests, criterios de aceptación. Emite veredicto estructurado. | review-report.md |
| 09 | /qa | Suite de tests automatizados + análisis de seguridad STRIDE. Genera informe de cobertura y análisis de amenazas. | qa-report.md |
| 10 | /staging | Despliega en entorno de staging. Ejecuta smoke tests. Registra la versión exacta desplegada. | staging-log.md |
| 11 | /verify | Validación en staging por agente verificador. Comprueba que los criterios de aceptación del PRD se cumplen en el entorno real. | verification-report.md |
| 12 | /production | Despliegue a producción. Solo ejecuta si qa-report.md y verification-report.md tienen estado «aprobado». Parada dura en caso contrario. | production-log.md |
| 13 | /retrospective | Cierre del ciclo. Agente de retrospectiva analiza el caso completo, identifica patrones, actualiza base de conocimiento. | retrospective.md |
| — | /close-case | Cierre inesperado. Cancela el caso en cualquier punto, documenta la razón, libera recursos, registra el estado en que quedó. | close-report.md |
El flujo estándar es lineal: cada comando solo puede ejecutarse si el anterior fue completado con éxito. No es una convención. Es una restricción que el sistema verifica antes de ejecutar. Si intentas lanzar /implement sin que exista un prd.md válido, el sistema no continúa.
Los artefactos como canal de comunicación entre agentes
Hay una decisión arquitectónica en este sistema que no es obvia a primera vista pero que explica por qué funciona donde otros sistemas fallan: los agentes no se comunican entre sí directamente. Se comunican a través de archivos en disco.
Cuando /prd ejecuta, su output es prd.md. Cuando /stories ejecuta, su primer paso es leer prd.md. El agente de historias no sabe nada sobre el agente de producto. No hay mensajes entre ellos, no hay llamadas a funciones compartidas, no hay estado en memoria que pase de uno al otro. Solo archivos.
Esta decisión tiene tres consecuencias que en producción valen cada bit de complejidad de setup:
El sistema es auditable. En cualquier momento puedes abrir la carpeta del caso y ver exactamente qué decidió cada agente, con qué input, en qué orden. Si el agente de arquitectura tomó una decisión que ahora parece incorrecta, puedes leer architecture.md, ver qué información tenía disponible, y entender por qué llegó a esa conclusión. No hay caja negra. Todo está en el sistema de archivos.
El sistema es recuperable. Si algo falla en el paso 9 —en /qa—, no tienes que empezar desde cero. Los artefactos de los pasos 1 a 8 siguen ahí. Puedes corregir lo que causó el fallo y relanzar desde el punto de fallo. La recuperabilidad no es una feature que añades encima. Es una consecuencia directa de que cada paso persiste su estado en disco.
El sistema puede probarse por partes. Puedes ejecutar /prd en aislamiento, con un discovery.md sintético, para verificar que el agente de producto genera el tipo de requisitos que esperas. Puedes probar /review dándole código real y verificando que el critic detecta los problemas que introduces intencionalmente. Cada comando es testeable de forma independiente porque sus inputs y outputs son archivos con formato conocido.
Trazabilidad de extremo a extremo
Una de las preguntas que recibo con más frecuencia cuando explico este sistema es: «¿cómo sabes que lo que está en producción responde a lo que el negocio pidió?» Es una pregunta que parece obvia pero que la mayoría de sistemas no pueden responder con precisión.
En este ciclo, la respuesta está en la cadena de referencias cruzadas entre artefactos.
Cada historia en stories.md tiene un campo prd-ref que apunta al ID del requisito en prd.md del que deriva. Cada commit de código lleva en el mensaje el ID de la historia que implementa. Cada entrada en production-log.md referencia el informe de QA aprobado que autorizó ese despliegue. La cadena completa queda así:
Necesidad de negocio (case.json)
    └─► Requisito funcional RF-03 (prd.md)
            └─► Historia US-07 [prd-ref: RF-03] (stories.md)
                    └─► Commit a3f91c2 [story: US-07] (git log)
                            └─► QA aprobado [commit: a3f91c2] (qa-report.md)
                                    └─► Deploy producción 2026-09-12 14:32 [qa: qa-report.md] (production-log.md)
Si en producción algo falla y el error está en el módulo que implementó US-07, puedes ir directamente al commit, a la historia, al requisito del PRD, y a la necesidad de negocio original. Todo el razonamiento que llevó a escribir ese código está disponible y es legible.
Esto no es una cuestión de elegancia técnica. Es la diferencia entre un sistema que puedes operar y un sistema que operas con los ojos cerrados esperando que no explote.
La puerta de producción: la parada dura
El punto del ciclo que genera más conversación —y la más interesante— es el comando /production.
La lógica de este comando es deliberadamente simple: antes de ejecutar el despliegue, lee qa-report.md y verification-report.md. Si ambos tienen estado approved, continúa. Si alguno tiene estado distinto —rejected, pending, requires-changes—, el comando se detiene completamente y devuelve el estado exacto que impide el avance.
No hay override. No hay flag --force. No hay modo de emergencia que permita saltarse la puerta.
Cuando presenté este diseño al equipo por primera vez, la reacción fue predecible: «¿y si hay una urgencia?» La respuesta que doy siempre es la misma: si hay una urgencia real, el camino más rápido hacia producción es resolver lo que el critic señaló, no buscar la forma de ignorarlo. Un sistema con override de seguridad disponible es un sistema cuya seguridad desaparece la primera vez que hay presión de calendario. Y siempre hay presión de calendario.
En los sistemas que operamos, la puerta dura de /production ha bloqueado despliegues en ocho ocasiones distintas. En cinco de ellas, el problema detectado era un bug real que habría llegado a usuarios. En dos, era una cobertura de tests insuficiente en una ruta crítica. En una, el critic de seguridad detectó una superficie de ataque que el equipo había pasado por alto. Ocho paradas. Cero incidentes de producción causados por esas features.
Puedes leer más sobre el diseño del agente critic y por qué la independencia estructural del revisor importa en el artículo sobre el agente crítico como componente de revisión.
Por qué los comandos son el proceso de governance
Hay una perspectiva sobre este sistema que me parece importante para directores y responsables de equipos técnicos: el ciclo de comandos no es la implementación del proceso de governance. El ciclo de comandos es el proceso de governance.
Si sabes qué comandos existen y cuáles se han ejecutado para un caso dado, sabes exactamente en qué punto del proceso está ese trabajo. No tienes que preguntar al equipo. No tienes que interpretar un diagrama de estado. Miras la carpeta del caso, ves qué artefactos existen, y sabes dónde está el trabajo y qué decisiones se tomaron hasta ahí.
Cada comando es un checkpoint. /discover completado significa que el equipo conoce el estado actual del sistema antes de tocar nada. /prd completado significa que los requisitos están documentados y son trazables. /review completado significa que un agente independiente ha validado la implementación. /production completado significa que QA y verificación dieron luz verde.
La diferencia con un proceso de governance convencional es que este es ejecutable y auditable por defecto. No depende de que alguien recuerde actualizar un ticket. No depende de que el equipo siga un procedimiento por disciplina. La estructura misma del sistema impide que el trabajo avance sin los checkpoints necesarios.
Para un director que gestiona múltiples proyectos en paralelo, esto tiene una implicación práctica directa: puedes saber el estado de cada proyecto mirando qué artefactos existen en cada carpeta. Sin reuniones de status. Sin informes manuales. El estado del proyecto es el estado de los artefactos.
El comando /close-case: diseñar para lo inesperado
El decimocuarto comando del ciclo, /close-case, existe para una categoría de situaciones que los sistemas bien diseñados suelen ignorar: los finales inesperados.
Un proyecto puede cerrarse antes de llegar a producción por muchas razones. El negocio cambia de prioridades. El descubrimiento inicial revela que la solución planteada no es la correcta. El PRD, una vez escrito, muestra que el problema real es diferente al que se identificó inicialmente. El cliente cancela.
Sin un comando de cierre explícito, estos casos quedan en un estado indefinido. Los artefactos están ahí pero incompletos. Los recursos siguen asignados nominalmente. No hay registro de por qué se canceló ni en qué estado quedó el trabajo.
/close-case fuerza una documentación mínima del cierre: motivo, estado en que quedaron los artefactos, qué puede reutilizarse. El artefacto close-report.md que genera no es burocracia. Es el registro que permite, semanas después, entender por qué ese trabajo existe a medias y qué decisión lo detuvo.
Implementar el ciclo: lo que nadie te dice
El ciclo de 14 comandos que describes sobre papel parece sencillo. La realidad de implementarlo en producción tiene algunas fricciones que vale la pena anticipar.
La primera es la definición de los formatos de artefacto. Cada artefacto tiene que tener un schema bien definido porque otros agentes lo leen. Si prd.md no tiene una estructura consistente, el agente de historias no puede extraer los IDs de requisito de forma fiable. La inversión en definir schemas de artefactos al principio se recupera con creces cuando el sistema escala.
La segunda es la gestión de versiones de artefactos. En producción, los requisitos cambian. prd.md puede actualizarse después de que stories.md ya existe. El sistema necesita una política explícita para estos casos: ¿se regeneran automáticamente las historias? ¿Se marca el artefacto derivado como potencialmente desactualizado? ¿Se bloquea el avance hasta que el equipo revise el impacto? No hay una respuesta única. Hay que decidirla y codificarla en el comportamiento de los comandos.
La tercera, y la más importante, es el diseño de los criterios de gate. La puerta dura de /production funciona porque los criterios que el critic evalúa son específicos y objetivos. Si los criterios son vagos —»el código debe ser de buena calidad»—, el critic no puede emitir un veredicto confiable y la puerta no tiene valor real. Diseñar criterios de aceptación operacionalizables es probablemente el trabajo más importante en la implementación del ciclo.
Si quieres entender cómo las skills se relacionan con estos comandos —qué capacidades activa cada etapa del ciclo— el artículo sobre skills en Claude Code y agentes especializados cubre esa capa en detalle.
Lo que el ciclo no resuelve
El ciclo de comandos resuelve el problema de estructura y trazabilidad. No resuelve el problema de calidad de los agentes individuales.
Si el agente de producto genera PRDs de mala calidad, el ciclo te dará PRDs de mala calidad trazables y auditables. La estructura no suple la calidad del razonamiento de cada agente. Lo que sí hace es hacer visible la calidad: cuando el critic de /review rechaza repetidamente outputs del agente de implementación por el mismo tipo de problema, tienes una señal clara de que ese agente necesita ajuste. Sin la estructura del ciclo, esa señal existe pero está enterrada en el ruido de operación. Con el ciclo, está en review-report.md, indexada, acumulable, analizable.
El ciclo no es el sustituto del buen diseño de agentes individuales. Es el entorno que hace visible cuándo ese diseño falla.
Preguntas frecuentes
¿Qué diferencia hay entre un comando y una skill en Claude Code?
Una skill es una capacidad especializada que un agente puede invocar —análisis de seguridad, generación de tests, revisión de código—. Un comando es una etapa del ciclo de vida del proyecto que orquesta qué agentes se activan, qué artefactos se generan y qué condiciones deben cumplirse para avanzar al siguiente paso. Los comandos pueden invocar múltiples skills en su ejecución.
¿Por qué los agentes se comunican a través de archivos en lugar de mensajes directos?
La comunicación a través de artefactos en disco hace el sistema auditable —puedes ver exactamente qué decidió cada agente y con qué información—, recuperable —si falla un paso, los artefactos anteriores persisten y no hay que repetir trabajo—, y testeable por partes —puedes ejecutar cualquier comando en aislamiento proporcionando artefactos de entrada sintéticos—. La alternativa, mensajes directos entre agentes, crea estado efímero que desaparece con el proceso y que no puede inspeccionarse ni reproducirse.
¿Qué ocurre si el critic bloquea el despliegue a producción?
El comando /production se detiene completamente y devuelve el estado exacto que impide el avance. No hay override disponible. El único camino es resolver los problemas identificados en el informe de QA o en el informe de verificación, y relanzar el flujo desde el punto de fallo. Esta parada dura es intencionada: un sistema con override disponible pierde su valor de gate en el primer proyecto bajo presión de calendario.
¿Cuándo usar /close-case en lugar de dejar el proyecto sin terminar?
Siempre que un proyecto se cancele antes de llegar a producción, independientemente del motivo. /close-case documenta el motivo del cierre, el estado en que quedaron los artefactos y qué trabajo puede reutilizarse. Sin ese registro, las carpetas de proyectos cancelados se convierten en deuda de contexto: trabajo del que no sabes si está en curso, en pausa o definitivamente descartado.
¿Es necesario implementar los 14 comandos desde el principio?
No. El ciclo completo es el objetivo, pero la implementación incremental funciona. El punto mínimo viable es tener /prd, /implement, /review y /production con la puerta dura activa. Eso ya te da trazabilidad básica y revisión independiente antes de producción. Los comandos de descubrimiento, planificación y retrospectiva añaden valor real pero no son la condición de partida para tener un sistema auditable.
Sobre Jorge Valero
Director de Tecnología e IA con más de 15 años de experiencia implantando sistemas de datos e inteligencia artificial en empresas medianas y grandes. Instructor y consultor especializado en ayudar a directivos a usar la IA como herramienta de decisión. Conoce mi trayectoria →