Seguridad en sistemas multi-agente: cinco capas que no puedes saltarte
El primer breach que vimos en un sistema multi-agente no fue un ataque externo. Fue un agente interno con acceso de escritura donde no lo necesitaba. El sistema llevaba tres semanas en producción. Funcionaba. Un agente de análisis de documentos tenía permiso de escritura en el directorio de contratos porque durante el desarrollo era conveniente que pudiera guardar borradores. Nadie retiró ese permiso antes del despliegue. Una semana después, un bug en el prompt del agente hizo que sobreescribiera un contrato firmado con una versión de borrador. El contrato tenía revisiones internas que nunca debían haber sido visibles al cliente. Recuperamos la versión correcta desde backup. El cliente nunca lo supo. Pero el susto nos costó dos días de análisis forense y una revisión completa de todos los permisos del sistema. Cada conexión que añades, por ejemplo con servidores MCP, es una puerta más que hay que vigilar.
Desde ese día, la seguridad en nuestros sistemas de agentes no es un checklist que hacemos antes de subir a producción. Es parte del diseño desde la primera línea de configuración.
Este artículo no es para equipos de seguridad. Es para directivos que están desplegando o a punto de desplegar sistemas de agentes con acceso a datos reales y la pregunta correcta que deben hacer no es «¿está seguro?» sino «¿qué capa de seguridad falta?»
Formación presencial · Madrid
¿Quieres salir de aquí sabiendo hacer esto en tu empresa el próximo 14 de noviembre?
En un día presencial montas tus departamentos agénticos con IA y construyes tu propia app. Sin conocimientos técnicos. Máx. 16 plazas.
Por qué la seguridad en agentes es distinta
Un sistema de agentes con acceso a producción no es una aplicación web con un formulario. Es un sistema autónomo que puede leer archivos, ejecutar comandos, escribir en bases de datos, llamar a APIs externas y tomar decisiones encadenadas sin intervención humana en cada paso. Eso lo hace poderoso. Y eso lo hace potencialmente destructivo si no está contenido.
El problema no es que los modelos sean malos. El problema es que un agente con acceso irrestricto puede hacer daño de formas que ningún desarrollador anticipó cuando escribió el prompt. No por malicia. Por ambigüedad. Por un edge case en los datos de entrada. Por un encadenamiento de acciones que en aislamiento son correctas pero combinadas producen un resultado que nadie quería.
La diferencia fundamental con la seguridad tradicional es esta: en una aplicación convencional, el sistema hace exactamente lo que le programaste. En un sistema de agentes, el sistema hace lo que interpreta que le pediste. Esa brecha de interpretación es donde viven la mayoría de los incidentes.
La conclusión que sacamos de esto es simple: la seguridad en sistemas de agentes tiene que ser estructural, no conductual. No puede depender de que el agente «haga lo correcto». Tiene que depender de que el agente físicamente no pueda hacer lo incorrecto.
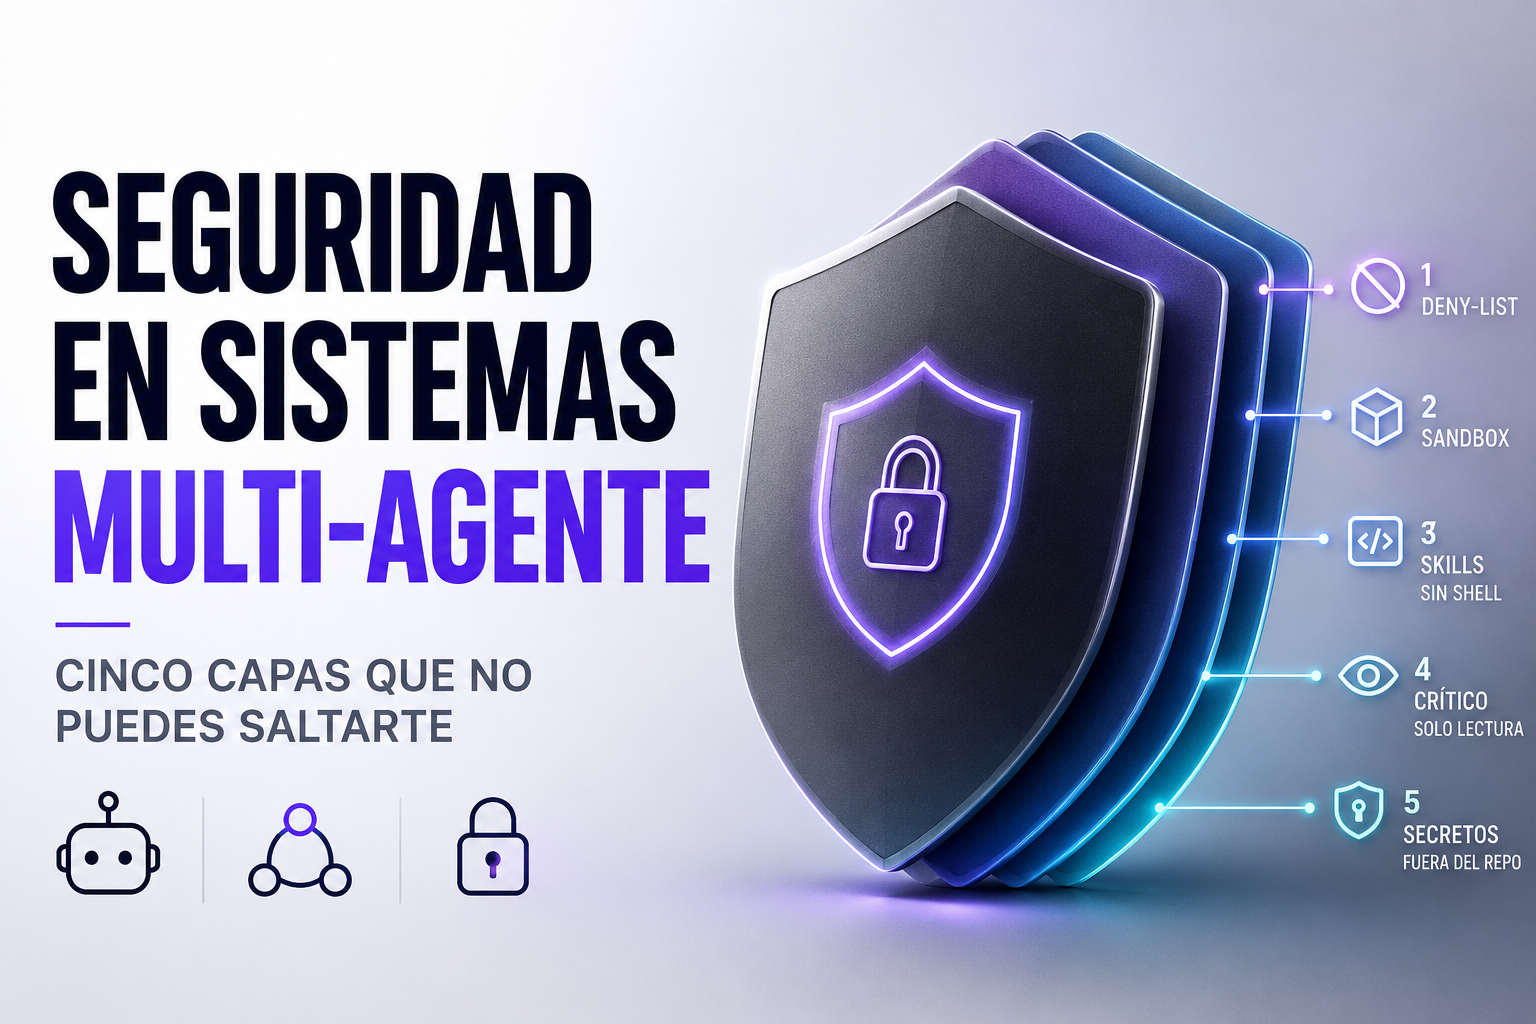
Las cinco capas de seguridad que no puedes saltarte
Capa 1: Lista de denegación en settings.json
La primera línea de defensa no es código. Es configuración. En settings.json definimos explícitamente qué herramientas están prohibidas por defecto para cada agente, independientemente de lo que diga el prompt o de lo que el orquestador le pida.
Las herramientas que bloqueamos de forma sistemática en todos nuestros sistemas:
{
  "denyTools": [
    "kubectl",
    "terraform apply",
    "git push --force",
    "rm -rf",
    "DROP TABLE",
    "DELETE FROM"
  ],
  "denyPaths": [
    ".env",
    ".env.*",
    "**/.secrets/**",
    "**/credentials/**"
  ]
}
El principio es el de mínimo privilegio llevado al nivel de herramientas: el agente solo puede hacer lo que está explícitamente permitido, no lo que no está explícitamente prohibido. La diferencia es fundamental. Una lista de denegación parcial deja huecos. Un modelo de permisos por inclusión —solo puedes lo que te damos— no los tiene.
Esto bloquea el acceso a archivos de secretos desde cualquier agente del sistema. No importa lo que pida el orquestador. No importa lo que diga el prompt. Si la herramienta o la ruta están en la lista de denegación, la llamada no se ejecuta. El agente recibe un error. El flujo se detiene. Y eso es exactamente el comportamiento correcto.
Capa 2: Sandbox por defecto
La ejecución de bash dentro de un agente está aislada en un sandbox. El agente puede ejecutar comandos —leer ficheros, llamar a scripts, procesar datos— pero no puede afectar al sistema fuera de su ámbito designado.
Lo que esto significa en práctica: si el agente ejecuta un comando que intenta escribir fuera de su directorio de trabajo, la operación falla. Si intenta acceder a un proceso del sistema fuera de su scope, la operación falla. El sandbox no es una red de seguridad de último recurso. Es la barrera primaria de contención.
El error que veo repetirse en equipos que despliegan rápido es desactivar el sandbox «temporalmente» durante el desarrollo porque dificulta ciertas operaciones de debugging. El problema es que ese «temporalmente» se convierte en el estado por defecto en producción. Si el sandbox dificulta el desarrollo, la respuesta correcta es revisar qué permisos necesita realmente el agente, no desactivar el sandbox.
En nuestro sistema, sandbox activado es el valor por defecto. Desactivarlo requiere una justificación explícita en la configuración del agente, documentada y revisable. No es una opción que se cambie sin dejar rastro.
Capa 3: Skills sin ejecución de shell
Las skills son capacidades reutilizables que los agentes invocan bajo demanda. Pueden hacer cosas sofisticadas: revisar código, analizar estructura, generar artefactos. Por diseño, algunas de esas operaciones no necesitan acceso shell. Para esas skills, la configuración correcta es disableSkillShellExecution: true.
Lo que esto hace: la skill se ejecuta en un entorno restringido que no puede lanzar procesos arbitrarios. Puede razonar, puede leer contexto, puede generar output. No puede ejecutar comandos del sistema operativo.
El vector de ataque que cierra esta capa es la inyección de prompt a través del contenido que analiza la skill. Si una skill de revisión de documentos puede lanzar procesos, y alguien coloca instrucciones maliciosas dentro de un documento que la skill analiza, el documento puede intentar hacer que la skill ejecute código. Con disableSkillShellExecution: true, aunque el prompt inyectado llegue al modelo, la capacidad de ejecución no está disponible.
No todas las skills necesitan esta restricción. Las que ejecutan deploys, corren tests o interactúan con infraestructura necesitan acceso shell. Pero las de análisis, revisión y generación de contenido raramente lo necesitan. El principio es el mismo: si no necesita el permiso, no lo tiene.
Capa 4: Agente crítico estructuralmente de solo lectura
El agente crítico —el que revisa el output antes de que salga del sistema— tiene una configuración específica que no es negociable: permissionMode: plan combinado con disallowedTools: [Write, Edit, Bash].
Lo que esto significa en términos concretos: el critic puede ver todo el sistema. Puede leer cualquier artefacto, cualquier log, cualquier decisión tomada por los agentes productores. No puede modificar nada. Puede razonar y puede emitir veredictos. No puede ejecutar acciones con efecto en el mundo.
Esta restricción no es un sistema de honor. No le estamos pidiendo al critic que no modifique cosas. Le estamos quitando las herramientas con las que podría hacerlo. La diferencia importa porque los sistemas de honor fallan bajo presión. Los sistemas arquitectónicos no.
Por qué importa que el critic no pueda escribir: si el critic puede modificar lo que está revisando, su evaluación ya no es independiente. Si encuentra un problema y puede corregirlo directamente, hay un incentivo implícito para corregir en lugar de rechazar. Eso contamina la señal de revisión. El critic tiene que poder decir «esto falla» sin la opción de arreglarlo. La independencia del juicio requiere independencia de herramientas.
En el sistema de desarrollo de software que tenemos en producción, el critic de seguridad —el que ejecuta el análisis de amenazas— está configurado exactamente así. Puede ver todo el código, todos los cambios, todos los artefactos del pipeline. Emite un veredicto: aprobado, aprobado con observaciones, o bloqueado. Si bloquea, el feature no avanza a staging. No hay override automático. No hay «intentar de nuevo». La puerta está cerrada hasta que se resuelva el problema que el critic identificó.
Capa 5: Secretos fuera del repositorio
Esta capa parece obvia. No lo es para la mayoría de equipos que despliegan rápido.
La implementación que usamos tiene dos elementos:
Primero, doble .gitignore: uno en la raíz del proyecto y uno dentro del directorio .secrets/. El doble gitignore existe porque el gitignore de la raíz puede ser sobreescrito por error en algún merge. El gitignore dentro del directorio de secretos es una segunda barrera que protege específicamente ese contenido aunque el gitignore raíz falle.
Segundo, en los archivos de configuración de MCPs, el patrón es ${VAR:-fallback}. Lo que hace: si la variable de entorno está definida, usa su valor. Si no está definida, usa el fallback. El fallback es siempre un valor seguro —una cadena vacía, un indicador explícito de «no configurado»— nunca una clave real.
// .mcp.json — patrón correcto
{
  "mcpServers": {
    "database": {
      "command": "npx",
      "args": ["-y", "@company/db-mcp"],
      "env": {
        "DB_CONNECTION_STRING": "${DB_CONNECTION_STRING:-}",
        "API_KEY": "${COMPANY_API_KEY:-NOT_SET}"
      }
    }
  }
}
El resultado: si el archivo .mcp.json llega a manos incorrectas —por un leak en el repositorio, por un snapshot del sistema que se comparte sin pensar— no contiene ninguna credencial real. Contiene referencias a variables de entorno que solo existen en el entorno de producción correcto.
La clave que se hardcodea en un archivo de configuración «porque es más cómodo» durante el desarrollo es la clave que aparece en un commit de hace seis meses cuando alguien hace un git log completo. Los secretos en el repositorio no se borran sobreescribiéndolos. Se borran rompiendo el historial de git, lo cual en un repositorio activo es una operación costosa y arriesgada.
STRIDE como gate obligatorio por feature
Las cinco capas anteriores son defensas estructurales: limitan lo que el sistema puede hacer por diseño. STRIDE es el análisis que ejecutamos antes de que cualquier feature nueva entre al sistema para entender qué nuevas amenazas introduce.
STRIDE son seis categorías de amenaza:
- Spoofing (suplantación): ¿puede un agente o componente externo hacerse pasar por otro?
- Tampering (manipulación): ¿puede alguien modificar datos en tránsito o en reposo?
- Repudiation (repudio): ¿puede un actor negar haber ejecutado una acción?
- Information Disclosure (divulgación): ¿puede información sensible llegar a quien no debe?
- Denial of Service (denegación de servicio): ¿puede el sistema ser saturado o bloqueado?
- Elevation of Privilege (elevación de privilegios): ¿puede un componente obtener permisos que no tiene?
En nuestro pipeline de desarrollo, el agente crítico de seguridad ejecuta el análisis STRIDE sobre cada feature antes de que avance a staging. El análisis no es un checklist genérico. Está contextualizado a lo que la feature específica hace, qué datos maneja, qué agentes involucra y qué nuevas superficies de ataque abre.
Si el análisis STRIDE identifica una amenaza no mitigada, la feature queda bloqueada. No hay override automático. El equipo de desarrollo tiene que demostrar cómo mitiga la amenaza identificada. Solo entonces el critic vuelve a ejecutar el análisis y decide si la mitigación es suficiente.
El valor de este gate no es que capture todos los problemas de seguridad posibles. Es que obliga al equipo a pensar en seguridad en el momento en que el coste de hacerlo es mínimo: antes de que la feature esté en producción con usuarios reales.
OWASP A01-A10 mapeado por capa arquitectónica
Las vulnerabilidades del OWASP Top 10 no son abstractas. En sistemas de agentes, cada una tiene una capa arquitectónica concreta donde se mitiga:
A01 — Broken Access Control: Cada consulta de un agente a una base de datos filtra por propietario. filter: { ownerId: currentAgent.id } en cada query, sin excepciones. Un agente no puede ver datos que no son suyos aunque tenga acceso técnico al sistema de almacenamiento.
A03 — Injection: Validación Zod en todos los límites del sistema. Cuando los datos entran desde fuera —formularios, webhooks, APIs externas— pasan por un esquema de validación antes de llegar a cualquier agente. Los prompts que se construyen con datos externos usan plantillas con separación explícita entre instrucción y datos.
A05 — Security Misconfiguration: Helmet activo en la capa de presentación. CORS con lista de orígenes permitidos explícita, nunca *. Rate limiting en todos los endpoints. Variables de entorno para toda la configuración sensible, sin hardcoding.
A07 — Authentication Failures: JWT con expiración corta (15 minutos) en la capa de presentación. El check de autenticación ocurre antes de que ningún agente reciba la petición. No hay endpoint que llegue a un agente sin haber pasado por el middleware de autenticación.
A09 — Logging and Monitoring Failures: Todos los eventos de seguridad se registran con formato estructurado: quién, qué, cuándo, con qué resultado. Los fallos de autenticación, los intentos de acceso a recursos sin permiso y los bloqueos del deny-list generan alertas inmediatas.
Por qué la seguridad no se añade después
He tenido esta conversación varias veces. El argumento siempre es el mismo: «primero lo hacemos funcionar, luego lo hacemos seguro». Y puedo entender la lógica. En un prototipo, en un PoC, en una demo interna, las capas de seguridad añaden fricción que ralentiza el desarrollo.
El problema es que los sistemas que «primero hacemos funcionar» tienen una tendencia notable a acabar en producción antes de que llegue el momento de «hacerlos seguros». No porque el equipo sea negligente. Sino porque el negocio tiene presión, el sistema funciona, y añadir capas de seguridad a un sistema en producción con usuarios reales es diez veces más costoso y más arriesgado que haberlas diseñado desde el principio.
Cuando añades seguridad a posteriori en un sistema de agentes, tienes que:
- Mapear todos los permisos que los agentes tienen actualmente y que nunca se documentaron
- Entender qué flujos dependen de esos permisos y cuáles se romperían si los retiras
- Añadir validación en fronteras del sistema donde los datos ya están circulando sin ella
- Convencer al equipo de que un sistema que «funciona» necesita cambios que lo harán más lento y más restrictivo
Ese proceso tiene un nombre en el sector: deuda de seguridad. Y como toda deuda, se acumula con intereses.
La alternativa no es hacer el sistema perfecto antes de lanzarlo. Es diseñar las cinco capas desde el día uno, aunque la implementación inicial sea simple. Sandbox activado por defecto. Deny-list configurado aunque esté vacío al principio. Secrets en variables de entorno aunque solo haya un entorno. El critic de solo lectura aunque solo revise un tipo de output. STRIDE aunque sea una checklist manual antes de ser un agente automatizado.
El coste de estas capas en día uno es mínimo. El coste de añadirlas en día cien, cuando el sistema tiene diez agentes, quince integraciones y datos reales de usuarios, es enorme.
Preguntas frecuentes
¿Es más seguro no dar acceso al agente a mis sistemas?
No. Es menos útil y no necesariamente más seguro. Un agente sin acceso a tus sistemas no puede hacer daño directo, pero tampoco puede hacer nada útil. La pregunta correcta no es «¿le doy acceso?» sino «¿qué acceso mínimo necesita para hacer exactamente lo que le pido, y cómo lo contengo para que no pueda hacer nada más?». Un agente con acceso cero y un agente con acceso total sin restricciones son ambos diseños incorrectos. El diseño correcto está en el medio: acceso preciso, contenido por las cinco capas.
¿El sandbox ralentiza el sistema en producción?
El overhead de rendimiento del sandbox es irrelevante en la práctica. El tiempo que tarda un agente en procesar un prompt, llamar a un modelo y generar una respuesta domina por completo sobre cualquier restricción de acceso al sistema de ficheros. En nuestros sistemas en producción, el sandbox no ha aparecido nunca como un cuello de botella de rendimiento. Sí ha aparecido como salvaguarda cuando un bug en el prompt hizo que un agente intentara acceder a rutas fuera de su scope. El sandbox lo bloqueó en microsegundos. Sin él, no habría habido señal de que algo había ido mal.
¿El análisis STRIDE tiene que ser un agente automatizado o puede ser manual?
Puede ser manual, especialmente al principio. Lo que importa es que ocurra antes de que la feature llegue a producción, no el mecanismo. Un checklist STRIDE manual que se revisa en cada PR es infinitamente mejor que un análisis STRIDE automatizado que nadie revisa porque «el agente ya lo hace». En nuestro sistema actual, el análisis STRIDE es un agente crítico configurado específicamente para eso. Llegamos ahí después de meses de hacerlo como proceso manual. La automatización vino cuando el volumen de features hacía el proceso manual insostenible. No antes.
¿Cómo gestiono los secretos en un equipo de varias personas?
El patrón ${VAR:-fallback} en .mcp.json gestiona el problema del repositorio. El problema de distribución —cómo cada miembro del equipo tiene los secretos correctos en su entorno local— se resuelve con un gestor de secretos centralizado (AWS Secrets Manager, HashiCorp Vault, o incluso un 1Password compartido con variables de entorno). Nunca por Slack, nunca por email, nunca en un documento compartido. La regla es simple: si el secreto existe fuera del gestor de secretos en cualquier forma legible por humanos que no sea el entorno local de la persona, está en el lugar equivocado.
¿Qué pasa si el agente crítico también tiene un bug en su configuración?
Es un riesgo real y es el argumento para no confiar en una sola capa. Las cinco capas son redundantes por diseño: si el critic falla, el sandbox sigue activo. Si el sandbox tiene un hueco, el deny-list sigue operando. Si alguien bypasea el deny-list, los secretos no están en el repo. La seguridad en profundidad no es burocracia. Es el reconocimiento de que cualquier capa individual puede fallar y la respuesta a eso es tener más capas, no una capa perfecta.
Sobre Jorge Valero
Director de Tecnología e IA con más de 15 años de experiencia implantando sistemas de datos e inteligencia artificial en empresas medianas y grandes. Instructor y consultor especializado en ayudar a directivos a usar la IA como herramienta de decisión. Conoce mi trayectoria →