Skills en Claude Code: qué son, para qué sirven y cómo diseñarlas bien
El patrón que más me sorprendió cuando empecé a ver sistemas multi-agente en producción no fue lo grande que podían ser. Fue lo redundante. Cada agente reinventaba las mismas capacidades: revisar seguridad, analizar arquitectura, comprimir contexto. Sin compartir nada. El mismo prompt de revisión de código reescrito cinco veces en cinco agentes distintos, con variaciones mínimas que nadie mantenía.
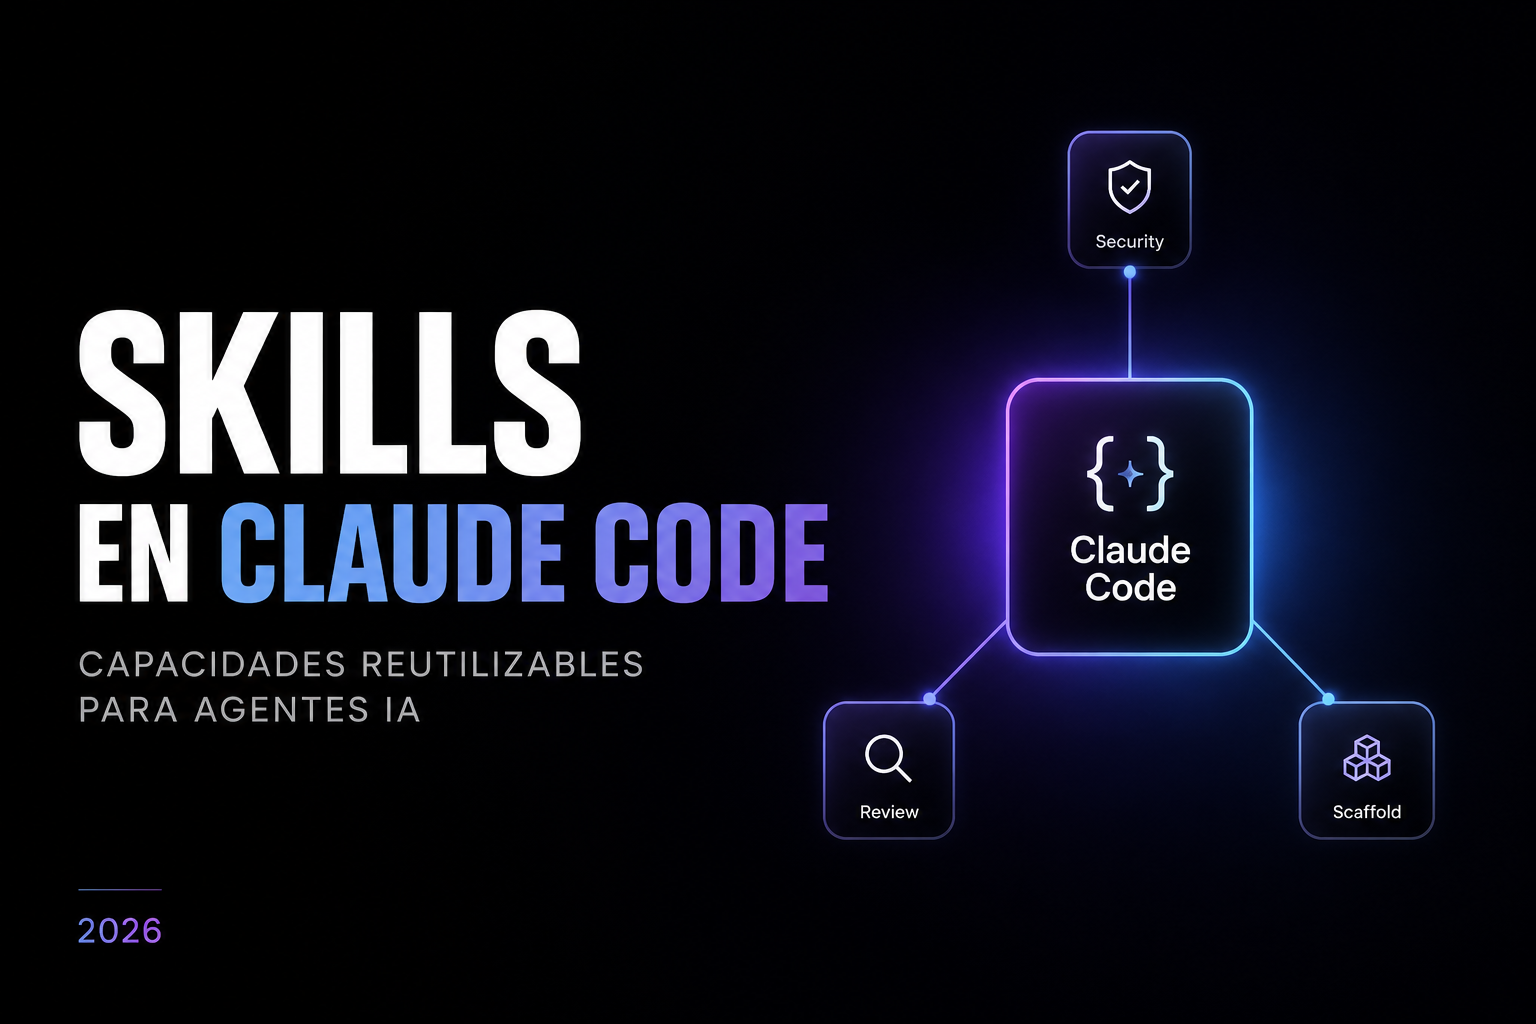
Las skills en Claude Code son la respuesta a ese problema. Son el mecanismo que convierte un conjunto de agentes aislados en un sistema coherente con una biblioteca de capacidades reutilizables. Y para que una skill llegue a tus herramientas reales, necesitas servidores MCP.
Este artículo cubre qué son, cómo están estructuradas, los dos patrones principales que existen y cuándo usar cada uno. Lo que no cubre —intencionadamente— es qué skills crear para los agentes específicos de tu empresa. Eso depende de tu contexto, de tus casos de uso y requiere análisis previo. Es, entre otras cosas, parte del trabajo que hacemos en el curso presencial.
Qué es una skill: comportamiento especializado bajo demanda
Una skill es una unidad de comportamiento especializado que el agente puede invocar cuando la necesita. No es un plugin. No es una herramienta. Es más parecido a un subproceso: cuando el agente llega a un punto del flujo donde necesita una capacidad específica, invoca la skill, esta ejecuta, y devuelve el resultado.
Formación presencial · Madrid
¿Quieres salir de aquí sabiendo hacer esto en tu empresa el próximo 14 de noviembre?
En un día presencial montas tus departamentos agénticos con IA y construyes tu propia app. Sin conocimientos técnicos. Máx. 16 plazas.
La analogía que uso con los directivos que no tienen formación técnica es esta: imagina que tienes un director de proyecto. Sabe hacer muchas cosas. Pero cuando necesita una revisión legal específica, llama al departamento legal. Cuando necesita un análisis financiero de precisión, llama a controlling. No intenta hacerlo él mismo desde cero cada vez. Las skills son esos departamentos especializados a los que el agente puede llamar.
Lo que diferencia una skill de un prompt cualquiera es la formalidad de la interfaz. Tiene nombre, descripción, contexto de activación y, opcionalmente, instrucciones al sistema sobre cómo ejecutarla. Esa formalidad es lo que hace posible que varios agentes distintos compartan la misma skill sin acoplarse entre sí.
Las skills viven en archivos Markdown dentro de la carpeta .claude/skills/ del proyecto. Cada archivo es una skill. La convención de nombrado es descriptiva: security-review.md, code-review.md, task-breakdown.md.
Anatomía de una skill: el frontmatter YAML
Cada archivo de skill tiene dos partes: un bloque de metadatos en YAML al principio —el frontmatter— y el cuerpo de la skill, que es el prompt o las instrucciones de ejecución.
El frontmatter tiene varios campos. Los que siempre aparecen:
El frontmatter de una skill define su identidad y comportamiento: un campo de nombre (el identificador que el agente invoca), un campo de descripción (lo que el orquestador lee para decidir cuándo usarla), y los campos que determinan el patrón de ejecución. La estructura exacta y cómo escribir cada campo es algo que trabajamos en detalle en el curso presencial.
El campo name es el identificador. Es lo que el agente invoca cuando necesita la skill. El campo description es lo que el orquestador lee para decidir si esa skill es la apropiada para el problema actual. Una descripción pobre aquí genera invocaciones incorrectas.
Los campos que determinan el comportamiento son context y agent. Estos dos campos son los que definen los dos patrones principales de skills.
Patrón 1: context:fork + agent — el especialista en contexto aislado
Cuando una skill tiene context: fork, Claude Code lanza la skill en un contexto separado del hilo principal. El subagente especialista recibe el encargo, trabaja, y devuelve el resultado. Pero lo que hace no contamina el contexto de la conversación principal.
Esto es más importante de lo que parece. El contexto en los sistemas de LLM es finito y caro. Un análisis de seguridad completo sobre un diff grande puede generar 15.000-20.000 tokens de razonamiento intermedio. Si ese razonamiento queda en el contexto principal, compite con el resto del trabajo del agente orquestador. Ralentiza. Distrae. En algunas arquitecturas, acaba expulsando información relevante del contexto por límite de ventana.
Con context: fork, ese razonamiento intermedio existe en el subagente y desaparece cuando termina. Lo que queda en el contexto principal es solo el resultado limpio: el checklist de seguridad, el listado de observaciones, la puntuación de arquitectura.
El campo agent especifica qué tipo de agente ejecuta la skill. El valor general-purpose usa el modelo por defecto. Puedes especificar modelos distintos por skill: skills de análisis crítico con modelos más potentes, skills de tareas estructuradas con modelos más rápidos y baratos.
Cuándo usar este patrón: cualquier tarea que requiera razonamiento profundo y perspectiva fresca. Revisiones, análisis comparativos, evaluación de calidad, retrospectivas. Cualquier situación donde quieres que el análisis lo haga un agente que no arrastra el sesgo del contexto acumulado.
Patrón 2: disable-model-invocation:true — ejecución determinista a coste cero
El segundo patrón es completamente distinto. Cuando una skill tiene disable-model-invocation: true en el frontmatter, Claude Code ejecuta la skill sin hacer ninguna llamada al modelo de lenguaje.
Una skill con disable-model-invocation: true tiene instrucciones completamente deterministas: el mismo input produce siempre el mismo output, sin razonamiento intermedio. El contenido exacto de esas instrucciones — qué carpetas crear, qué archivos generar, qué configuración aplicar — es algo específico de cada proyecto y equipo. En el curso lo construimos directamente para los proyectos de cada participante.
El coste de invocar esta skill es exactamente cero en tokens de modelo. No hay inferencia. El sistema lee las instrucciones, las ejecuta de forma determinista y devuelve el resultado.
El ahorro real de disable-model-invocation en proyectos con uso intensivo de skills es consistente y predecible. Las invocaciones de scaffolding y bootstrap ocurren muchas veces: al iniciar proyecto, al crear módulos, al generar documentación estructurada.
Cuándo usar este patrón: cuando el contenido de la skill ya está definido de antemano y no necesita razonamiento para producirse. Scaffolding de proyecto, generación de estructura de carpetas, bootstrap de configuración, plantillas de documentos con formato fijo, salidas estructuradas donde el esquema no varía.
La distinción clave entre los dos patrones es si el trabajo requiere razonamiento o no. Si requiere razonamiento: context: fork. Si es estructura predeterminada: disable-model-invocation: true.
Cómo es un inventario de skills en producción
Para dar concreción a esto, puedo describir cómo se distribuye un sistema de skills maduro en producción, sin entrar en los nombres y contenidos exactos de cada una —porque esos son específicos del sistema concreto y del equipo que los usa.
Un sistema de skills para consultoría tecnológica de tamaño mediano tiene en el entorno de diez a quince skills. La distribución habitual es esta: la gran mayoría son skills de análisis y revisión (arquitectura, seguridad, calidad de código, rendimiento, diseño de API, compresión de contexto). Un número pequeño son skills puramente estructurales, sin llamada al modelo, para scaffolding y documentación de cierre.
Esa distribución es reveladora por sí sola. El análisis y la revisión son la mayor parte del trabajo intelectual del sistema. Las tareas puramente estructurales son pocas pero se invocan con frecuencia, de ahí que el ahorro de coste sea real aunque el número de skills sin modelo sea pequeño.
Qué skills específicas crear para un sistema concreto —sus nombres, sus descripciones, sus criterios de activación— es el trabajo que hacemos en el curso presencial, donde cada participante lo diseña para sus propios agentes y su propia operación.
Por qué las skills son la capa de reutilización del sistema
Sin skills, cada agente de un sistema multi-agente tiene que llevar embebida toda su capacidad en su propio contexto de sistema. El agente de código lleva su prompt de security review. El agente de infraestructura lleva otro prompt de security review ligeramente diferente. El agente de integración lleva una tercera versión.
Tres implementaciones del mismo conocimiento. Tres superficies a mantener cuando cambia el estándar de seguridad. Tres lugares donde puede haber inconsistencia.
Las skills rompen ese patrón. Hay una sola implementación de security-review. Cualquier agente del sistema puede invocarla. Cuando el equipo aprende algo nuevo sobre OWASP o cambia el estándar del proyecto, actualiza un archivo. Todos los agentes que invocan esa skill se benefician automáticamente.
La analogía de ingeniería es clara: las skills son el equivalente a las librerías compartidas en programación tradicional. No duplicas el código de manejo de errores en cada servicio. Lo extraes a una librería, la reutilizas, la mantienes en un lugar. Las skills hacen lo mismo para el conocimiento operativo del sistema de agentes.
Hay otro beneficio menos obvio: la testabilidad. Una skill con interfaz definida se puede probar de forma aislada. Puedes ejecutar solo la skill de security review sobre un diff conocido y verificar que el output es el esperado, sin tener que ejecutar el flujo completo del agente orquestador. Eso acelera mucho la detección de regresiones cuando iteras el sistema.
Cómo diseñar una skill que funcione en producción
El error más común al crear skills es la ambigüedad en la descripción. La descripción es lo que el orquestador lee para decidir si invocar la skill. Si es vaga, el orquestador la invoca en momentos incorrectos o no la invoca cuando debería.
Una descripción buena especifica: qué analiza, sobre qué input, qué produce como output, y cuándo es el momento correcto de invocarla. Una descripción mala solo nombra la skill: «Hace una revisión de seguridad.»
El cuerpo de la skill debe ser lo suficientemente específico para producir outputs consistentes, pero no tan rígido que no se adapte a contextos distintos. Las skills de revisión suelen tener bien esto: definen el marco de evaluación (OWASP, principios de Clean Architecture, métricas de performance) pero dejan al modelo espacio para interpretar los hallazgos específicos del caso.
Las skills de scaffolding con disable-model-invocation son exactamente lo contrario: cuanto más específicas y literales, mejor. El objetivo es reproducibilidad total. Si la skill genera una estructura de carpetas, debe generar exactamente esa estructura, siempre.
Antes de poner una skill en producción, vale la pena hacerse estas preguntas: ¿Este conocimiento se va a necesitar en más de un agente? Si la respuesta es sí, es candidato a skill. ¿El contenido requiere razonamiento o es estructura fija? La respuesta determina el patrón. ¿Cómo sabré que la skill funciona correctamente? Si no tienes criterio de verificación, el diseño está incompleto.
Lo que no toco aquí —deliberadamente— es qué skills específicas crear para tu caso de uso. Eso depende de los agentes que tengas, de los flujos de trabajo de tu empresa y de los cuellos de botella que hayas identificado en producción. No hay un inventario universal. El de 12 skills que describí arriba es el de ese sistema concreto, con esos agentes, para esos casos de uso.
Relación con los comandos y los agentes
Las skills no reemplazan a los comandos ni a los agentes. Son una capa distinta con un propósito distinto.
Los comandos en Claude Code son flujos de trabajo que el usuario invoca directamente: /deploy, /nueva-convocatoria, /security-review. El punto de entrada es el humano.
Los agentes orquestadores son entidades autónomas que coordinan trabajo, toman decisiones y delegan a subagentes. El punto de entrada es un objetivo.
Las skills son capacidades que tanto los comandos como los agentes pueden invocar. Son el nivel más bajo de la jerarquía: comportamiento reutilizable sin flujo de trabajo propio. Un comando puede invocar una skill. Un agente puede invocar la misma skill. La skill no sabe desde dónde la están llamando.
En sistemas maduros, esta separación de capas es lo que hace el sistema mantenible. Cambias la implementación de una skill sin tocar los agentes ni los comandos que la usan. Añades una skill nueva sin rediseñar los flujos. La arquitectura del sistema de agentes refleja los principios de diseño que cualquier ingeniero senior reconocería: bajo acoplamiento, alta cohesión, reutilización explícita.
Preguntas frecuentes sobre skills en Claude Code
- ¿Una skill puede invocar a otra skill?
- Sí. El subagente que ejecuta una skill tiene acceso al sistema de skills del proyecto. Esto permite composición: una skill de «revisión completa» puede invocar internamente skills de seguridad, arquitectura y código. Hay que tener cuidado con la profundidad de anidamiento y el coste acumulado, pero el patrón funciona y es útil para revisiones exhaustivas.
- ¿Cuántas skills tiene sentido tener en un proyecto?
- No hay un número correcto. El sistema de 12 skills que describí arriba es grande para un proyecto de una persona, normal para un equipo pequeño. Lo que sí hay son señales de exceso: si tienes dos skills con descripciones casi idénticas, probablemente son una sola. Si tienes una skill que nadie ha invocado en tres semanas, examina si tiene sentido mantenerla. La regla práctica: empieza con las skills que eliminen la mayor duplicación. Añade cuando identifiques el problema, no de forma preventiva.
- ¿Se pueden compartir skills entre proyectos distintos?
- Las skills se definen a nivel de proyecto en
.claude/skills/. No hay en este momento un mecanismo nativo de librería global de skills compartida entre proyectos. La solución que usan los equipos es mantener un repositorio de skills de referencia y copiar las relevantes al proyecto. No es lo ideal desde el punto de vista de mantenimiento, pero funciona. Para skills de revisión estándar (OWASP, Clean Architecture) que no cambian mucho entre proyectos, la copia manual con versión tiene coste bajo. - ¿Cómo mido si una skill funciona bien?
- Para skills con
context:fork, el criterio es la calidad del output: ¿el checklist de seguridad identifica problemas reales? ¿Las observaciones de arquitectura son accionables? Esto requiere revisión humana periódica, especialmente al principio. Para skills condisable-model-invocation, el criterio es determinismo: el mismo input siempre produce el mismo output. Se puede automatizar: ejecutar la skill sobre un caso conocido y comparar el resultado con el esperado. Cualquier desviación es un bug en la skill. - ¿Hay diferencia entre una skill y un agente especialista?
- La diferencia es de alcance y persistencia. Un agente tiene memoria, contexto propio, posiblemente configuración de herramientas específicas y puede coordinarse con otros agentes. Una skill es más ligera: tiene un propósito puntual, no persiste entre invocaciones y no tiene identidad propia más allá del archivo que la define. Para tareas de análisis recurrentes, la skill es la abstracción correcta. Para procesos complejos con estado, el agente es la abstracción correcta.
Sobre Jorge Valero
Director de Tecnología e IA con más de 15 años de experiencia implantando sistemas de datos e inteligencia artificial en empresas medianas y grandes. Instructor y consultor especializado en ayudar a directivos a usar la IA como herramienta de decisión. Conoce mi trayectoria →