Cómo conectar agentes, skills, comandos y herramientas: arquitectura completa
Cuando diseñamos la arquitectura completa por primera vez, llevábamos meses construyendo agentes por separado. Teníamos un agente que redactaba bien, otro que analizaba datos y un tercero que coordinaba tareas. Cada uno funcionaba aceptablemente en aislamiento. El problema era que juntos formaban un sistema frágil: si un agente fallaba, el resto no tenía forma de saberlo. Si necesitaban datos de un sistema externo, cada uno lo llamaba de manera diferente. Si algo iba mal en producción, no había traza clara de qué había pasado. — Jorge Valero, Director de Tecnología e IA.
El insight que cambió cómo lo montamos fue este: no estábamos construyendo agentes, estábamos construyendo capas. Y las capas tienen que estar conectadas de forma explícita, con contratos claros entre ellas, o el sistema entero se vuelve imposible de mantener.
La mayoría de equipos implementa una o dos de estas capas y se pregunta por qué el sistema es frágil. Esta es la arquitectura completa.

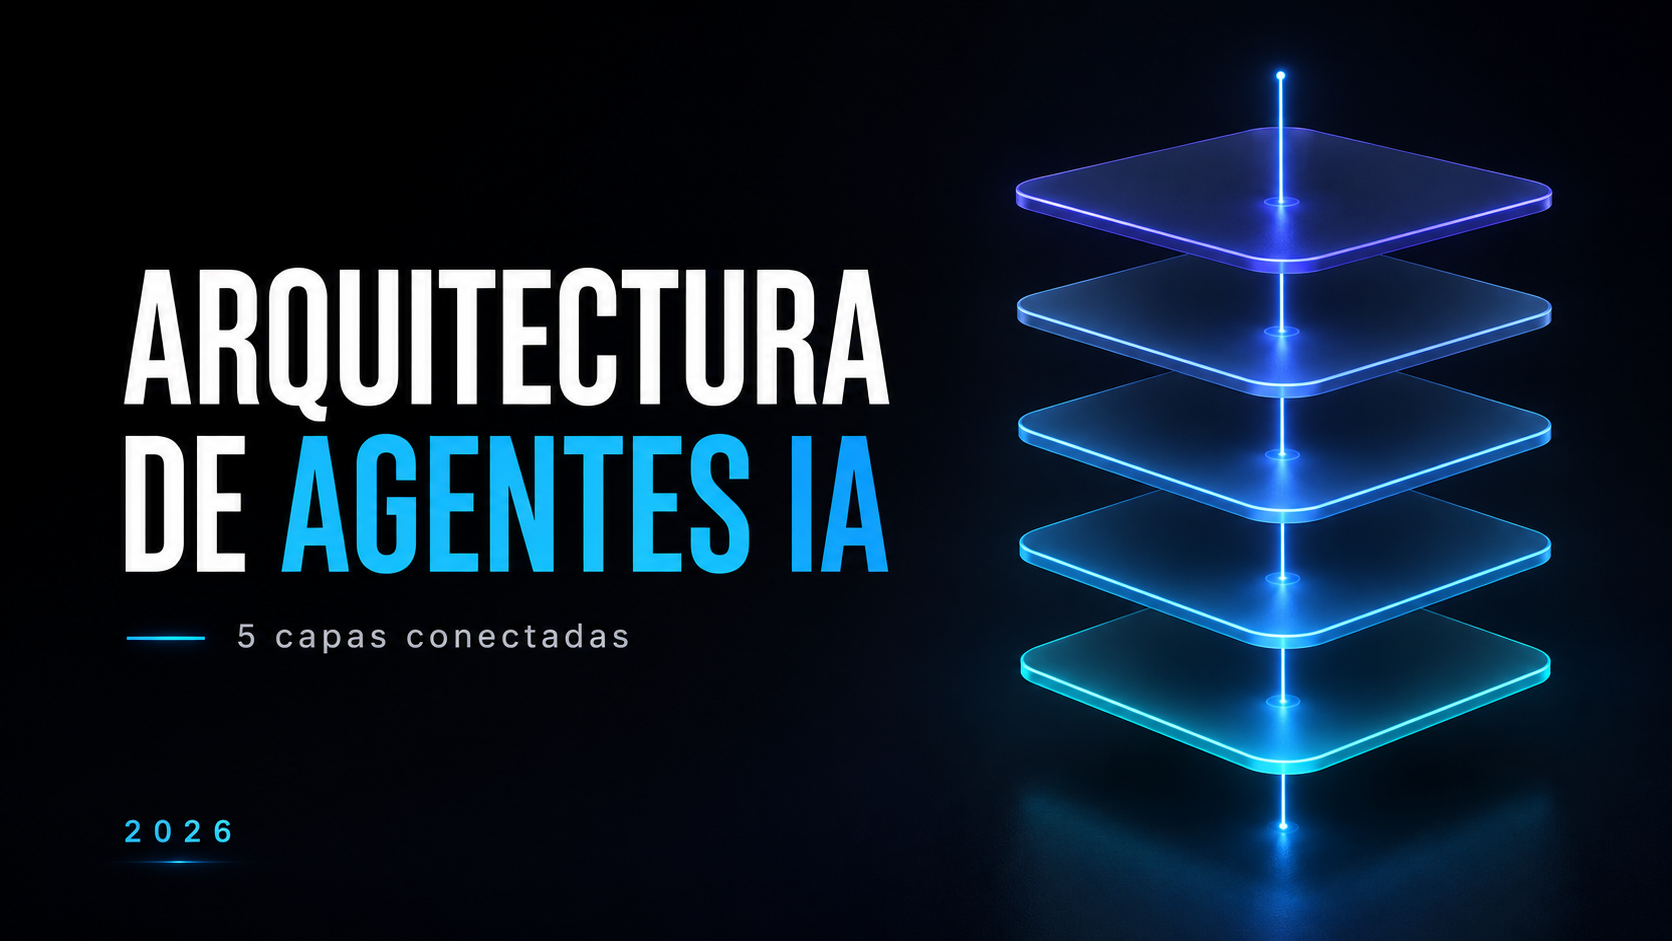
Las cinco capas de la arquitectura
Antes del diagrama, la intuición: cada capa tiene una responsabilidad única y no la delega hacia arriba ni hacia abajo. Las capas superiores orquestan; las inferiores ejecutan. La comunicación entre capas sigue protocolos estrictos. No hay atajos.
Formación presencial · Madrid
¿Quieres salir de aquí sabiendo hacer esto en tu empresa el próximo 14 de noviembre?
En un día presencial montas tus departamentos agénticos con IA y construyes tu propia app. Sin conocimientos técnicos. Máx. 16 plazas.
┌────────────────────────────────────────────────────────────────┐
│  CAPA 5 — COMANDOS                                             │
│  Ciclo de vida del proyecto · Gates · Artefactos en disco      │
│  /new-application · /prd · /implement · /production · ...      │
└────────────────────┬───────────────────────────────────────────┘
                     │ invoca
┌────────────────────▼───────────────────────────────────────────┐
│  CAPA 4 — ORQUESTADOR  (1 instancia · modelo Opus)             │
│  Routing table · Síntesis · Coordinación de especialistas      │
│  NO hace trabajo de dominio · SÍ decide quién lo hace          │
└──────┬─────────────┬────────────────┬──────────────────────────┘
       │             │                │  invocaciones paralelas
┌──────▼──────┐ ┌────▼──────┐ ┌──────▼──────┐
│  AGENTE A   │ │  AGENTE B │ │  AGENTE C   │  CAPA 3 — AGENTES
│  Redactor   │ │ Analista  │ │  Crítico    │  Especialistas
│  (bounded   │ │ (bounded  │ │  (read-only │  Dominio acotado
│   domain)   │ │  domain)  │ │   by design)│  Permisos explícitos
└──────┬──────┘ └────┬──────┘ └──────┬──────┘
       │             │               │
       └─────────────┼───────────────┘
                     │ invoca
┌────────────────────▼───────────────────────────────────────────┐
│  CAPA 2 — SKILLS                                               │
│  Capacidades bajo demanda · Reutilizables entre agentes        │
│  Con o sin llamada al modelo · Stateless                       │
│  /review · /security-review · /deploy · /caveman-commit · ...  │
└────────────────────┬───────────────────────────────────────────┘
                     │ accede via
┌────────────────────▼───────────────────────────────────────────┐
│  CAPA 1 — MCPs / HERRAMIENTAS                                  │
│  Acceso a sistemas externos · CRM · ERP · Drive · Slack        │
│  GitHub · Jira · Notion · Base de datos · APIs propias         │
│  Los agentes NO llaman APIs directamente — todo pasa por aquí  │
└────────────────────────────────────────────────────────────────┘

Comunicación entre agentes: SIEMPRE a través de artefactos en disco.
El agente B lee lo que escribió el agente A. No hay mensajes directos.
Capa 1: MCPs y herramientas — el único punto de acceso a sistemas externos
El error más común que veo en equipos que empiezan a montar agentes: cada agente llama directamente a las APIs que necesita. Un agente de marketing llama a la API de HubSpot. Un agente analista llama directamente a la base de datos. Un agente de comunicación llama a Slack.
Esto parece más simple al principio. Y lo es — hasta que necesitas auditar qué hizo el sistema, rotar credenciales, añadir rate limiting, o simplemente entender por qué algo salió mal.
La capa de MCPs (Model Context Protocol) es la capa de abstracción entre los agentes y los sistemas externos. Todo agente que necesite acceder a un CRM, leer un documento de Drive, escribir en Notion, consultar GitHub o mandar un mensaje a Slack lo hace a través de un MCP, no directamente.
Las consecuencias prácticas son importantes:
- Credenciales centralizadas. Las API keys viven en un único lugar — el servidor MCP — y nunca se distribuyen entre agentes. Rotar una credencial es una operación, no doce.
- Logging centralizado. Cada llamada a un sistema externo queda registrada en el mismo lugar, con el mismo formato, independientemente de qué agente la hizo.
- Rate limiting y reintentos uniformes. No duplicas la lógica de manejo de errores en cada agente.
- Permisología granular. El orquestador puede conceder a un agente acceso de lectura al CRM pero no escritura. El MCP lo aplica.
Los MCPs disponibles en un sistema bien diseñado cubren: sistemas de archivos del proyecto, CRM y ERP corporativos, herramientas de gestión de proyecto (Jira, Linear, Notion), repositorios de código, plataformas de comunicación, bases de datos internas, y APIs propias de negocio.
Capa 2: Skills — capacidades reutilizables bajo demanda
Una skill es una capacidad especializada que un agente puede invocar sin tener que reimplementarla. La distinción crucial es que las skills son reutilizables entre agentes distintos y pueden o no implicar una llamada al modelo.
Ejemplos del mundo real:
/review— Revisa código en el diff actual buscando bugs, calidad y mejoras. La usa el agente implementador, pero también puede invocarla el agente de QA./security-review— OWASP A01-A10 sobre los cambios pendientes. La usa cualquier agente antes de una propuesta de merge./caveman-commit— Genera el mensaje de commit en formato conciso. La usa el agente de implementación, no necesita saber cómo construir un buen commit message./deploy— Build → push → SSH → symlinks → pm2 → verificación. Una skill que encapsula el procedimiento completo de despliegue./simplify— Detecta código duplicado y propone refactorizaciones. Reutilizable por cualquier agente que toque código.
Las skills sin llamada al modelo son especialmente interesantes: son funciones deterministas que ejecutan lógica de negocio o llaman a herramientas sin necesidad de inferencia. Son las más rápidas y baratas del sistema.
Lo que hace poderosa a esta capa es la reutilización. Si tienes diez agentes y cada uno reimplementa la lógica de revisión de seguridad, tienes diez versiones que divergirán. Si todos invocan la misma skill /security-review, tienes una versión que mejoras una sola vez y todos los agentes se benefician.
Puedes profundizar en cómo diseñar y estructurar skills en este artículo sobre skills en Claude Code.
Capa 3: Agentes especialistas — dominio acotado y permisos explícitos
Un agente especialista tiene tres características que lo definen:
- Dominio acotado. El agente redactor sabe de contenidos. No sabe de infraestructura. El agente analista sabe de datos. No toma decisiones de arquitectura. Esta restricción no es una limitación — es lo que hace el sistema predecible.
- Permisos explícitos. Cada agente tiene declarado exactamente a qué MCPs puede acceder y con qué nivel (lectura, escritura, ejecución). Un agente que no tiene concedido acceso de escritura al repositorio, no puede hacer git push aunque lo intente.
- Read-only por defecto. A menos que se conceda explícitamente permiso de escritura, un agente opera en modo lectura. El agente crítico — el que revisa el trabajo de otros — es siempre read-only. No puede modificar nada de lo que evalúa.
La lista de agentes en un sistema maduro incluye roles muy distintos: redactor, analista de datos, arquitecto de software, implementador, crítico de código, agente de QA, agente de despliegue, agente de documentación, agente de comunicación, agente de seguridad.
Cada uno tiene su propio CLAUDE.md que define su identidad, sus capacidades y sus límites. Cuando el orquestador lo invoca, lo hace pasándole contexto relevante, no todo el contexto disponible.
El agente crítico merece mención especial. Su único trabajo es leer lo que han producido otros agentes y señalar problemas. No puede modificar código, no puede hacer commits, no puede llamar a sistemas externos de escritura. Esta restricción estructural es lo que le da credibilidad — un crítico que puede modificar lo que critica no es un crítico, es un actor con conflicto de intereses.
Para una exploración en profundidad de cómo funcionan estos agentes internamente, ver el artículo sobre agentes especialistas en IA.
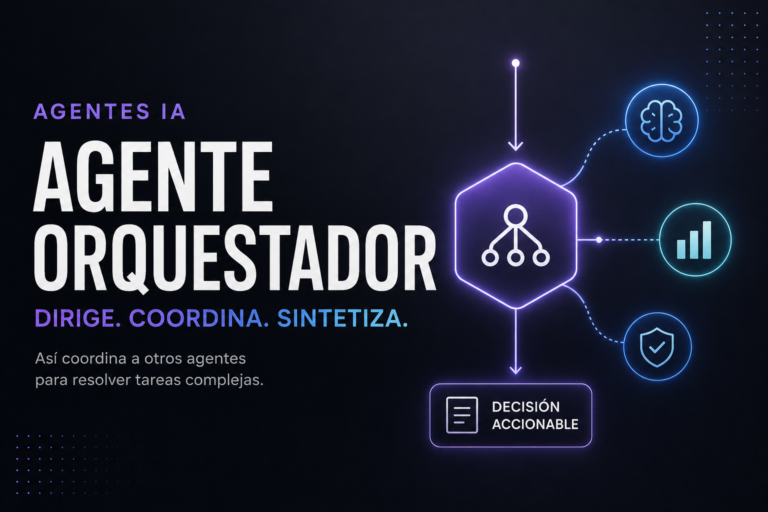
Capa 4: El orquestador — el único que ve el cuadro completo
El orquestador es el único componente del sistema que tiene visión global. Y es el único punto donde merece la pena usar el modelo más capaz — en nuestro caso, Opus.
Hay una regla importante: solo hay un Opus en el sistema. Los agentes especialistas corren en modelos más pequeños y especializados. El orquestador en Opus. Mezclar esto añade coste sin añadir calidad.
Lo que hace el orquestador:
- Routing table. Decide qué agente especialista responde a cada tarea. Si llega una petición de «revisar el código del PR #47», el orquestador sabe que eso va al agente crítico de código, no al agente redactor.
- Invocaciones paralelas. Cuando una tarea puede descomponerse en subtareas independientes, el orquestador las lanza en paralelo. El análisis de rendimiento y la revisión de seguridad pueden correr simultáneamente.
- Síntesis. Cuando varios agentes producen outputs, el orquestador los integra en una respuesta coherente. No promedia — interpreta, pondera y decide qué conflictos resolver y cómo.
- Gestión de contexto. El orquestador decide cuánto contexto pasa a cada agente. Pasar todo el contexto a todos los agentes es caro e ineficiente. El orquestador filtra lo relevante por especialidad.
Lo que NO hace el orquestador: trabajo de dominio. El orquestador no redacta contenidos, no analiza datos, no revisa código. Si empieza a hacer eso, has perdido la separación de responsabilidades y el sistema se vuelve un monolito disfrazado.
Puedes leer más sobre el diseño del orquestador en este artículo dedicado al agente orquestador.
Capa 5: Comandos — el ciclo de vida como protocolo
Los comandos son el mecanismo por el que el sistema avanza de fase a fase en el ciclo de vida de un proyecto. No son simplemente «atajos de teclado» — son gates que verifican que la fase anterior está completa antes de permitir avanzar a la siguiente, y producen artefactos específicos en disco.
El flujo real de 14 comandos que usamos en proyectos de desarrollo:
| # | Comando | Qué produce | Gate de entrada |
|---|---|---|---|
| 1 | /new-application |
Estructura de carpetas + CLAUDE.md del proyecto | — |
| 2 | /discover |
Mapa de codebase existente + dependencias | Proyecto inicializado |
| 3 | /prd |
Product Requirements Document en disco | Discovery completo |
| 4 | /stories |
User stories priorizadas desde el PRD | PRD aprobado |
| 5 | /plan |
Plan técnico por capas | Stories definidas |
| 6 | /spec |
Especificación técnica detallada | Plan aprobado |
| 7 | /implement |
Código + tests | Spec completa |
| 8 | /review |
Informe de revisión de código | Implementación completa |
| 9 | /qa |
Resultados de tests + cobertura | Review aprobado |
| 10 | /staging |
Deploy en entorno de staging | QA pasado |
| 11 | /verify |
Checklist de verificación en staging | Staging desplegado |
| 12 | /production |
Deploy en producción | Verify aprobado |
| 13 | /retrospective |
Lecciones aprendidas en disco | Producción estable |
Cada comando es atómico: o completa correctamente y produce su artefacto, o falla y el sistema lo registra sin avanzar. No hay estados intermedios opacos.
Los artefactos en disco son la clave de la auditabilidad. Si alguien pregunta «¿por qué se tomó esta decisión de arquitectura?», la respuesta está en el artefacto de /plan. Si algo falla en producción, el artefacto de /verify muestra exactamente qué se comprobó antes de aprobar el despliegue.
La comunicación entre agentes: artefactos, no mensajes directos
Este es el principio de diseño que más cambia la forma de pensar el sistema: los agentes no se comunican entre sí directamente. El agente B no le manda un mensaje al agente A. En cambio, el agente A escribe un artefacto en disco, y el agente B lo lee.
Un ejemplo concreto: cuando el agente implementador termina su trabajo, escribe un fichero implementation-report.md con el resumen de cambios, los ficheros tocados y las decisiones tomadas. El agente crítico abre ese fichero como entrada para su revisión. No hay canal directo entre ellos.
Las consecuencias de este diseño son profundas:
- Auditabilidad total. Cada paso del sistema deja un registro en disco. Puedes reproducir exactamente qué vio cada agente y qué decidió.
- Recuperabilidad. Si el sistema falla en la fase de QA, puedes reiniciarlo desde el artefacto de implementación sin perder trabajo anterior.
- Depuración determinista. Si el agente crítico produce una revisión incorrecta, puedes inspeccionar exactamente qué leyó. No hay «conversación interna» opaca.
- Paralelismo seguro. Varios agentes pueden leer el mismo artefacto simultáneamente sin conflictos.
La alternativa — agentes que se pasan contexto en memoria, en colas de mensajes, o a través del estado de la conversación — parece más simple hasta que tienes que depurar algo. En ese momento, la falta de trazabilidad se convierte en el problema principal.
Seguridad por capas: la deny-list y el principio de mínimo privilegio
La seguridad en este tipo de sistemas no se implementa en un único punto — se aplica en cada capa, con controles distintos:
Deny-list a nivel de sistema. Hay comandos que ningún agente puede ejecutar bajo ninguna circunstancia: kubectl, terraform apply, git push --force, modificaciones directas de ficheros .env. Esta lista está hardcodeada en la configuración del sistema, no en los prompts de los agentes. Los prompts pueden modificarse; la deny-list no.
Sandbox para agentes de implementación. Los agentes que escriben código ejecutan en entornos aislados sin acceso a credenciales de producción. Pueden leer el repositorio; no pueden publicar a producción directamente.
Skills sin acceso a shell. Algunas skills están diseñadas explícitamente sin capacidad de ejecutar comandos del sistema operativo. El agente crítico usa solo skills de este tipo. Aunque le pidieran que ejecutara algo, no puede.
Agente crítico read-only estructural. No es una instrucción en el prompt — es una restricción a nivel de permisos de MCP. El agente crítico no tiene acceso a ningún MCP de escritura.
Secrets fuera del repositorio. Las credenciales nunca están en el código, nunca en los artefactos en disco visibles para los agentes, nunca en los logs. El servidor MCP las inyecta en el momento de la llamada, sin exposición.
Ejemplo real: de /new-application a producción con las cinco capas
Para hacer concreto todo lo anterior, este es el recorrido de una feature típica a través de las cinco capas.
El producto owner invoca /new-application. La capa de comandos crea la estructura del proyecto, genera el CLAUDE.md con el contexto relevante, y produce el artefacto de inicialización.
El orquestador lee ese artefacto y decide que el siguiente paso requiere el agente de discovery. Invoca al especialista pasándole el contexto mínimo necesario.
El agente de discovery usa la skill /discover, que a su vez accede a través del MCP de sistema de archivos al codebase existente y al MCP de GitHub para ver el historial de cambios recientes. Escribe su artefacto en disco: un mapa de dependencias y una lista de áreas de riesgo.
El orquestador sintetiza ese artefacto e invoca al agente arquitecto para generar el PRD. El agente arquitecto no accede a GitHub directamente — todo pasa por el MCP. Produce el artefacto prd.md.
El comando /implement llega. El orquestador lanza en paralelo el agente implementador y el agente de seguridad. El implementador escribe código. El agente de seguridad revisa el PRD con la skill /security-review. Ambos escriben sus artefactos. El orquestador lee ambos, detecta un conflicto entre una decisión de implementación y una observación de seguridad, y lo resuelve antes de avanzar.
El agente crítico — read-only, sin acceso a escritura — lee el artefacto de implementación y produce un informe de revisión. Si el informe tiene observaciones bloqueantes, el comando /review no produce artefacto de aprobación y el pipeline se detiene.
Una vez que todos los gates están verdes, el comando /production activa la skill /deploy, que a través del MCP de infraestructura ejecuta el proceso completo de despliegue. El artefacto final es el registro de deploy con timestamps, checksums y resultado de la verificación post-deploy.
Todo esto ha quedado trazado en disco, paso a paso, con artefactos legibles por humanos. Si algo falla en producción la semana siguiente, el recorrido completo está disponible.
Por qué los sistemas parciales son frágiles
La mayoría de las implementaciones que veo tienen alguna de estas configuraciones incompletas:
- Solo agentes, sin orquestador. Los agentes se llaman entre sí en cadena fija. Cuando el orden correcto cambia según el contexto, el sistema no puede adaptarse.
- Skills pero sin sistema de comandos. Hay capacidades bien definidas pero no hay ciclo de vida. El sistema no sabe en qué fase está ni qué se ha producido antes.
- Agentes con acceso directo a APIs. Sin capa de MCPs, cada rotación de credenciales es una operación de cirugía distribuida. La seguridad es inconsistente entre agentes.
- Comunicación por memoria compartida. Los agentes se pasan estado a través del contexto de la conversación. No hay artefactos. Si algo falla, no hay forma de reproducir qué vio cada agente.
- Un único modelo para todo. El orquestador y los especialistas corriendo en el mismo modelo, con el mismo acceso, sin distinción de roles. Caro, lento y difícil de depurar.
Ninguno de estos sistemas está «roto» — todos producen resultados en condiciones normales. La fragilidad se muestra cuando algo falla, cuando hay que depurar, cuando las credenciales rotan, cuando el equipo crece y hay que mantener el sistema.
Cómo diseñar la arquitectura para tu empresa
Entender la arquitectura conceptualmente es el primer paso. Implementarla para tu empresa — con tus sistemas, tus procesos, tus datos y tus restricciones específicas — es otro nivel de trabajo.
Requiere mapear qué sistemas externos necesitan MCPs en tu contexto concreto. Definir qué agentes especialistas tienen sentido para tu operativa. Decidir qué skills son reutilizables y cuáles son específicas de cada agente. Establecer los gates del ciclo de vida que corresponden a tu forma de trabajar, no a la nuestra.
Eso es lo que trabajamos en el curso presencial: no la teoría de las cinco capas, sino cómo montar cada capa específicamente para tu empresa, con tus departamentos reales, usando Claude Code en el entorno de tu equipo.
Profundiza en cada capa
- Skills en Claude Code: capacidades reutilizables para que cada agente no reinvente lo mismo
- Comandos en Claude Code: cómo se lanza y se encadena el trabajo del sistema
- MCP en Claude Code: la conexión de los agentes con tus herramientas reales
- Gestión del contexto: qué ve el agente en cada momento y cómo no saturarlo
- Agentes críticos: el agente que revisa en lugar de producir
- Seguridad multiagente: permisos y límites cuando hay varios agentes trabajando a la vez
Preguntas frecuentes
¿Cuántos agentes necesita un sistema funcional mínimo?
Tres es suficiente para empezar: un agente especialista, un orquestador y un agente crítico. Con estos tres tienes la separación fundamental entre quien hace el trabajo, quien coordina y quien revisa. Los sistemas más complejos tienen docenas de agentes, pero la complejidad debe crecer desde la necesidad, no desde el diseño inicial.
¿Se puede implementar esta arquitectura sin usar Claude Code?
La arquitectura es agnóstica del tooling. Los principios — capas separadas, comunicación por artefactos, permisos explícitos, deny-list estructural — se aplican con cualquier framework de agentes. Claude Code los implementa de una forma específica, pero los conceptos valen para cualquier sistema de orquestación de agentes.
¿Cuál es el coste de tener un orquestador en Opus?
Opus es significativamente más caro por token que los modelos menores. La razón por la que merece la pena usarlo solo en el orquestador es que las decisiones de routing y síntesis requieren el mejor juicio disponible, y son pocas comparadas con el volumen total de inferencia del sistema. Los agentes especialistas procesan más tokens pero pueden usar modelos más económicos sin perder calidad en su dominio específico.
¿Qué pasa cuando un agente especialista falla?
Depende del gate del comando. Si el agente falla sin producir artefacto, el comando detecta la ausencia del artefacto esperado y detiene el pipeline. Si el agente produce un artefacto marcado como fallido, el orquestador decide si reintenta, escala al humano o bloquea el avance. La clave es que el fallo queda registrado en disco — no hay fallos silenciosos.
¿La comunicación por artefactos no es más lenta que la comunicación directa?
En latencia pura, sí es marginalamente más lento. En términos de tiempo total del ciclo — incluyendo depuración, recuperación de fallos y mantenimiento — es sustancialmente más rápido. Los sistemas con comunicación por estado compartido son más rápidos en la demo, pero acumulan deuda de operabilidad que se paga en producción.
¿Cómo se gestiona la versión de los artefactos si hay que reiniciar un paso?
Los artefactos se nombran con timestamp o con hash del estado del pipeline en el momento de su creación. Si se reinicia un paso, el nuevo artefacto no sobreescribe el anterior — crea uno nuevo. El orquestador siempre lee el artefacto más reciente de cada fase. Esto permite comparar lo que produjo un intento fallido con lo que produjo el reintento exitoso.
Sobre Jorge Valero
Director de Tecnología e IA con más de 15 años de experiencia implantando sistemas de datos e inteligencia artificial en empresas medianas y grandes. Instructor y consultor especializado en ayudar a directivos a usar la IA como herramienta de decisión. Conoce mi trayectoria →